Introducción
Si usas Redis en un entorno compartido — ya sea una instancia usada por múltiples microservicios, múltiples equipos o múltiples tenants — una única clave grande puede degradar el rendimiento de todos los demás consumidores al mismo tiempo. No es una exageración: es como funciona Redis internamente, e ignorar este comportamiento en producción sale caro.
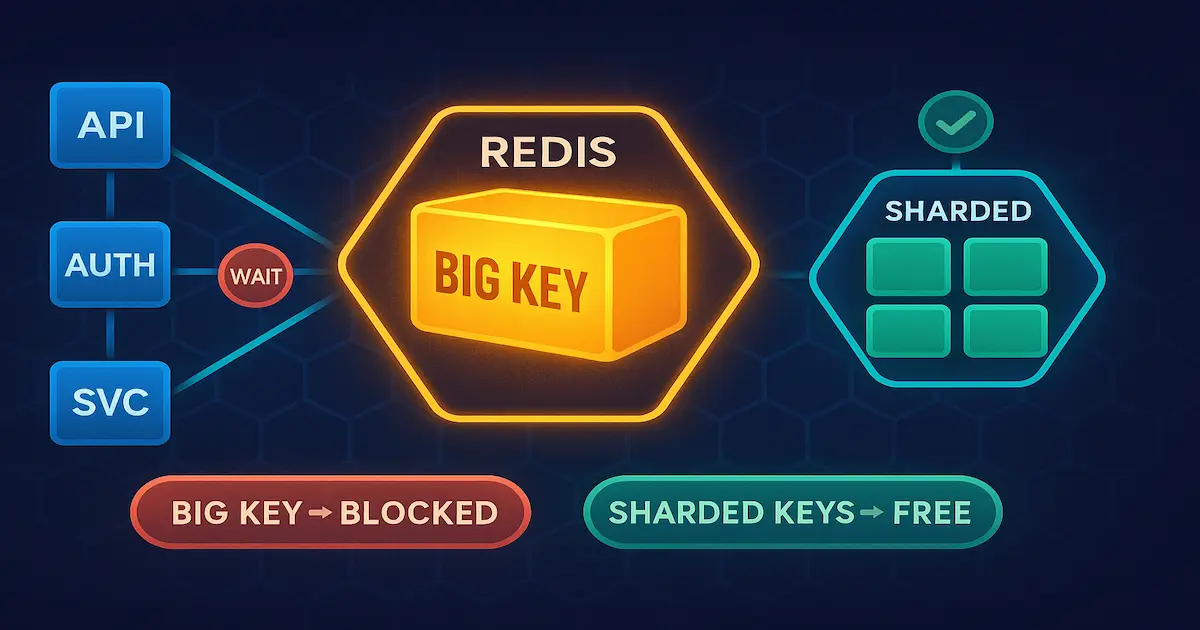
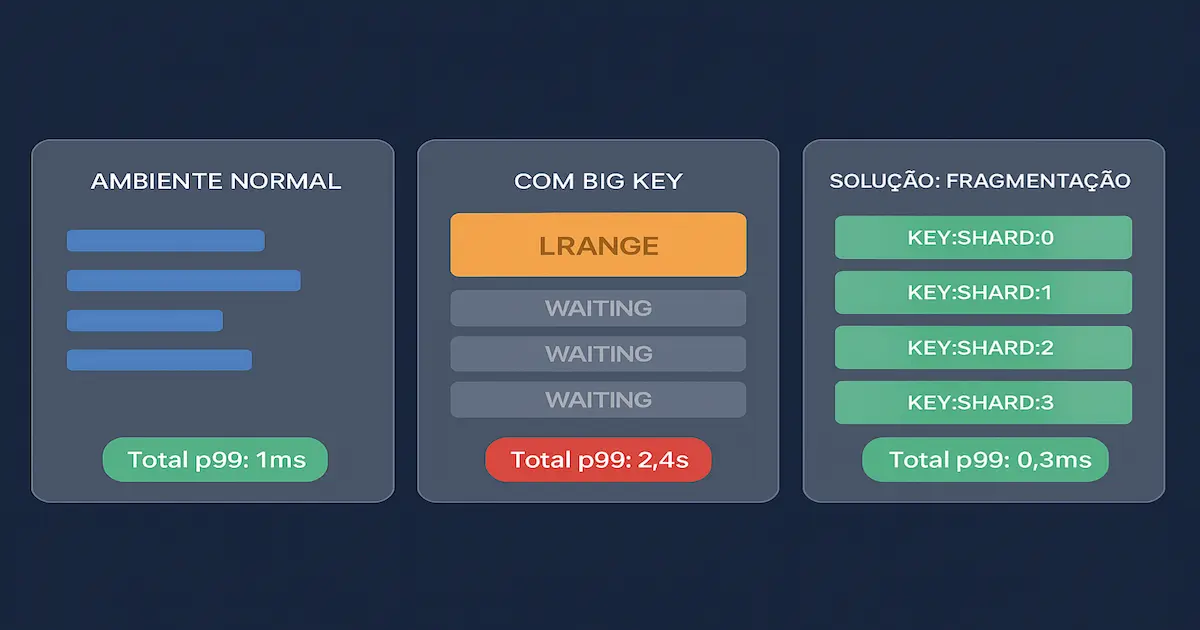
El problema de las claves grandes (big keys) en Redis existe porque el servidor es single-threaded para las operaciones de datos. Cuando un comando accede o manipula una clave que contiene cientos de megabytes — sea una lista con 500 mil elementos, un hash con 200 mil campos o un string binario de 50 MB — todo el event loop queda bloqueado procesando esa operación. Todos los demás clientes, de servicios completamente diferentes, quedan esperando en la cola. En entornos compartidos esto es fatal.
En este artículo voy a mostrar qué caracteriza a una clave grande en Redis, por qué el impacto se amplifica en entornos multi-tenant, cómo detectar big keys en producción, y las estrategias concretas para eliminar o mitigar el problema — con ejemplos en C# usando StackExchange.Redis.
Qué es una “Big Key” en Redis
Redis no tiene un límite fijo que defina cuándo una clave es “grande”. La comunidad y la documentación oficial usan el término big key para describir claves cuyo costo de procesamiento o de memoria es desproporcionado en relación con el workload general de la instancia.
En la práctica, los límites que suelen surgir como referencia son:
| Tipo de Dato | Considerado “grande” a partir de |
|---|---|
| String / Binary | > 5 MB |
| List | > 10.000 elementos o > 10 MB |
| Hash | > 10.000 campos |
| Set | > 10.000 miembros |
| Sorted Set | > 10.000 miembros |
| Stream | > 10.000 mensajes pendientes |
Estos números no son absolutos — dependen del hardware, de la versión de Redis y del patrón de acceso. Pero son referencias sólidas para alertas de monitoreo.
ℹ️ Información: Redis 7.0+ introdujo mejoras en las estructuras de datos internas (como Listpack reemplazando a ZipList), lo que cambió ligeramente los umbrales a partir de los cuales las estructuras se “promueven” a representaciones mayores. El concepto de big key, sin embargo, sigue siendo el mismo.
Diferencia entre clave grande y clave caliente
Es común confundir big key con hot key. Son problemas diferentes:
- Big key: clave con mucho volumen de datos — el problema es el costo de CPU/memoria para procesar el dato.
- Hot key: clave accedida con altísima frecuencia — el problema es la contención en el slot de hash (relevante en Redis Cluster).
Una clave puede tener ambos problemas al mismo tiempo, pero las soluciones son distintas. Este artículo se enfoca en las big keys.
Cómo Procesa Redis los Comandos (y por qué importa)
Para entender el impacto de las big keys, es necesario entender cómo Redis ejecuta los comandos. Redis usa un event loop single-threaded para procesar las operaciones de datos. Esto significa:
- El servidor recibe un comando de un cliente.
- El event loop ejecuta el comando hasta el final antes de procesar cualquier otro.
- Solo después se procesa el siguiente comando de la cola.
Esta arquitectura es una de las razones por las que Redis es tan rápido para operaciones simples: sin locks, sin context switching entre threads. El costo es que una operación lenta lo bloquea todo.
| |
⚠️ Atención: Comandos como
LRANGE key 0 -1,SMEMBERS key,HGETALL keyyKEYS *son O(N) — el costo crece linealmente con el tamaño de la estructura. En una clave con 500 mil elementos, esto puede tardar segundos.
El modelo de I/O de Redis no es bloqueante — pero el procesamiento sí
Es importante separar dos conceptos:
- I/O: Redis usa multiplexación de I/O (epoll/kqueue), por lo que aceptar conexiones y leer datos de red no es bloqueante.
- Procesamiento de comandos: la ejecución del comando en sí es single-threaded y bloqueante para los demás clientes.
Redis 6.0 introdujo threads de I/O para la lectura y escritura de red, pero la ejecución de los comandos sigue siendo single-threaded en el thread principal. El problema de las big keys no se resolvió con ese cambio.
Impacto en Entornos Compartidos
En un entorno donde una única instancia de Redis sirve a múltiples microservicios o a múltiples tenants de un SaaS, el impacto de una big key se amplifica porque:
1. La latencia afecta a todos, no solo al culpable
Si el servicio de informes lee una clave con 300 mil registros cada hora, eso introduce picos de latencia para el servicio de autenticación, el servicio de notificaciones y cualquier otro que comparta la misma instancia — aunque esos servicios estén funcionando perfectamente.
2. El consumo de memoria se disputa
Redis mantiene todos los datos en memoria. Una big key que ocupa 500 MB reduce el espacio disponible para todos los demás tenants. Cuando Redis alcanza maxmemory, inicia la política de eviction (expulsión de claves), que puede descartar datos críticos de otros servicios.
3. Las operaciones de snapshot y replicación se vuelven más lentas
Cuando Redis genera un snapshot RDB (persistencia) o replica datos a una réplica, las big keys aumentan el tiempo del fork() y el tamaño del archivo. En instancias cloud (AWS ElastiCache, Azure Cache for Redis), esto puede causar fallos de replicación o penalizaciones de rendimiento durante la sincronización.
4. Dificultad de depuración y trazabilidad
En un entorno compartido, identificar quién creó la big key y qué servicio es el responsable exige una instrumentación cuidadosa. Sin un namespacing adecuado en las claves, rastrear el origen del problema puede llevar horas.
Cómo Detectar Big Keys en Producción
Redis ofrece herramientas nativas para detectar big keys. Estos son los enfoques principales:
redis-cli –bigkeys
El comando más simple para un escaneo inicial:
| |
La salida muestra las claves más grandes por tipo de dato. El problema es que este comando usa SCAN internamente y puede tardar en instancias grandes. En producción, prefiere ejecutarlo en horarios de menor carga.
MEMORY USAGE — verificación puntual
Para comprobar el tamaño de una clave específica:
| |
SCAN + MEMORY USAGE — escaneo automatizado en C#
Para un monitoreo programático con StackExchange.Redis:
| |
📂 Código Fuente: El ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/Cache/Redis/
📝 Ejemplo: En un entorno con 2 millones de claves, un escaneo con
pageSize = 500ypattern = "relatorio:*"limita el alcance solo al namespace problemático, reduciendo el tiempo de escaneo de horas a minutos.
Redis Latency Monitoring
Para detectar el impacto en tiempo real, activa el monitoreo de latencia:
| |
Estrategias para Evitar Big Keys
Detectar el problema es el primer paso. Resolverlo es más interesante. Existen cuatro enfoques principales:
1. Fragmentación de datos (Sharding)
En lugar de una única clave grande, distribuir los datos en múltiples claves más pequeñas usando un campo de particionamiento:
| |
2. Serialización eficiente con compresión
Uno de los mayores culpables de los strings grandes es la serialización ingenua de objetos complejos. Cambiar JSON por un formato binario + compresión reduce drásticamente el tamaño:
| |
💡 Consejo: La compresión GZip típica reduce los payloads JSON entre un 60 y un 80%. Un objeto de 5 MB puede bajar a 800 KB — lo que lo saca de la clasificación de “big key” hacia un tamaño manejable. Pero atención: la compresión tiene un costo de CPU, evalúa el trade-off para datos accedidos con alta frecuencia.
3. TTL obligatorio para las claves de caché
Las claves sin TTL en entornos compartidos tienden a acumular datos indefinidamente. Implementa una política de TTL obligatoria:
| |
4. Namespacing y segregación por tenant
En entornos multi-tenant, usa prefijos obligatorios para identificar el origen de las claves. Esto facilita el diagnóstico y permite políticas de limpieza selectivas:
| |
Ejemplo Práctico
Voy a mostrar un escenario real: un servicio de informes que cargaba todos los registros de transacciones del mes en una única clave de Redis como “caché” — y estaba hundiendo el rendimiento de los demás servicios del mismo clúster.
El problema original
| |
Este código crea una clave que puede tener 80 MB en Redis, sin TTL, y que se lee entera en cada acceso. Cada lectura bloquea el event loop durante cientos de milisegundos.
La solución refactorizada
| |
Con este enfoque, cada clave pasa de 80 MB a ~30 KB. El event loop se libera en microsegundos, y los demás servicios compartidos dejan de sufrir latencia por culpa del servicio de informes.
Consejos y Buenas Prácticas
Define umbrales de alerta en el CI/CD: antes de un deploy, verifica si los nuevos patrones de clave respetan los límites de tamaño. Un pipeline de pruebas de carga con
redis-cli --bigkeyspuede prevenir el problema antes de que llegue a producción.Usa TTL en absolutamente todas las claves: en entornos compartidos, una clave sin TTL es una clave que crecerá indefinidamente. Configura
maxmemory-policy allkeys-lruen Redis para que, aunque alguna clave escape sin TTL, Redis pueda descartarla cuando sea necesario.Nunca uses
KEYS *en producción: el comandoKEYSbloquea Redis mientras recorre todo el keyspace. Usa siempreSCANconMATCHyCOUNTpara escaneos iterativos y no bloqueantes.StackExchange.Redisexpone este comportamiento a través deIServer.KeysAsync().Monitorea
redis-cli --latency-history: latencias recurrentes por encima de 50ms son señal de big keys o hot keys. Configura alertas de latencia en Redis y correlaciónalas con los patrones de clave que se están accediendo en ese momento.Separa workloads en instancias distintas cuando sea posible: si un servicio de informes inevitablemente necesita claves grandes, aíslalo en una instancia de Redis dedicada. El costo de una instancia extra es mucho menor que el impacto de latencia en los servicios críticos de un entorno compartido.
Prefiere las estructuras nativas de Redis en lugar de strings JSON grandes: un
HASHcon 1.000 campos es más eficiente que unSTRINGcon un JSON de 1.000 propiedades. Redis puede acceder a campos individuales del hash sin deserializar toda la estructura, ahorrando CPU y memoria.Revisa el diseño al usar Redis como base de datos: Redis es excelente como caché de corta duración, pub/sub y contadores. Cuando empieza a recibir colecciones completas de entidades para “persistencia temporal”, es señal de que el diseño necesita revisión — probablemente una base de datos relacional o documental es la herramienta adecuada para ese dato.
Resumen Objetivo
- Big key en Redis — clave cuyo volumen de datos es desproporcionado respecto al workload; los límites prácticos son 5 MB para strings y 10.000 elementos para listas/hashes/sets. A partir de esos valores, las operaciones O(N) bloquean el event loop durante cientos de milisegundos.
- Event loop single-threaded — Redis procesa un comando a la vez en el thread principal (incluso en Redis 6.0+ con I/O threads). Una big key bloquea a todos los demás clientes de la instancia mientras se procesa.
- Entornos compartidos — en instancias de Redis usadas por múltiples microservicios o tenants, una big key creada por un único servicio introduce latencia para todos los demás, independientemente de su comportamiento.
- Comandos O(N) peligrosos —
LRANGE key 0 -1,SMEMBERS key,HGETALL key,KEYS *ySUNIONSTOREson los principales vectores de bloqueo cuando se aplican a claves grandes. Prefiere variantes paginadas comoHSCAN,SSCANyZSCAN. - Detección en producción —
redis-cli --bigkeysrealiza un escaneo por tipo;MEMORY USAGE key SAMPLES Ndevuelve el tamaño exacto en bytes incluido el overhead;LATENCY LATESTidentifica comandos con latencia anómala. - Fragmentación como solución — dividir una big key en múltiples claves más pequeñas usando sharding por campo elimina el bloqueo y permite paralelismo en la lectura. Un hash con 100.000 campos puede dividirse en 16 shards de ~6.250 campos cada uno.
- TTL obligatorio — toda clave en un entorno compartido debe tener expiración. La ausencia de TTL es la principal causa de acumulación de big keys en producción. Configura
maxmemory-policy allkeys-lrucomo red de seguridad.
Lee También
- Cuello de Botella en Bases de Datos: Mensajería y Paginación — estrategias para resolver cuellos de botella de escritura y lectura con mensajería y paginación eficiente en EF Core 8+.
- Worker y Background Service en .NET: Alto Volumen — cómo procesar grandes volúmenes de datos en segundo plano sin sobrecargar los servicios principales.
- Programación Asíncrona en C#: async/await y Threads — fundamentos de programación asíncrona en C# para evitar bloqueos en operaciones de I/O, incluido el acceso a cachés.
- Paginación en APIs REST con C# y EF Core: Guía Práctica — patrones de paginación para evitar devolver grandes volúmenes de datos de una sola vez.
Referencias
- Redis Big Keys — Documentación Oficial — especificaciones de tipos de datos y comportamiento interno de Redis por versión.
- Redis Memory Optimization — Best Practices — guía oficial de optimización de memoria en Redis, que cubre la codificación interna de las estructuras de datos.
- StackExchange.Redis — Documentación — documentación de la biblioteca cliente .NET para Redis, incluido el uso de SCAN y MEMORY USAGE.
- Redis Latency Problems — Troubleshooting Guide — guía oficial de diagnóstico de latencia en Redis, con foco en comandos bloqueantes.
- Anti-Patterns in Redis Usage — Redis Labs Blog — antipatrones comunes de uso de Redis identificados por el equipo de Redis Ltd., incluidas big keys y hot keys.
- Redis SCAN command — documentación del comando SCAN con ejemplos de escaneo no bloqueante para uso en producción.
Al comentar, aceptas nuestra Política de Privacidad, Términos de Uso, Política de Eliminación de Datos.