Introducción

Paginar resultados parece simple: agregas .Skip(offset).Take(pageSize) y listo. Pero cuando la tabla tiene 10 millones de registros, el usuario está en la página 5.000, la base de datos es Oracle 11g o el cliente exige scroll infinito sin duplicados — esa simplicidad desaparece rápidamente.

La paginación es una de las decisiones arquitectónicas de mayor impacto en APIs REST, y la elección equivocada puede significar consultas de 8 segundos, resultados inconsistentes o un backend que se bloquea bajo carga. Existen al menos cinco estrategias distintas, cada una con trade-offs claros: Offset, Keyset (Seek), Cursor de base de datos, Token opaco y Time-based. Cada base de datos — SQL Server, Oracle y PostgreSQL — implementa estas estrategias con sintaxis y comportamiento ligeramente distintos.

En este artículo vas a entender en profundidad cuándo usar cada estrategia, cómo la implementa cada base de datos y cómo codificar todo con EF Core 8.0+ en C#. Si quieres una visión más amplia de los cuellos de botella de lectura y escritura en bases de datos, lee también el artículo Cuello de Botella en Bases de Datos: Mensajería y Paginación.

Requisitos previos: C# intermedio, EF Core básico, familiaridad con SQL. También se recomienda el artículo sobre programación asíncrona con C#.

📦 Código fuente: La implementación completa de este artículo está en el repositorio blog-zocateli-sample en GitHub. Clónalo, explóralo y adáptalo a tu contexto.


Por Qué la Paginación Equivocada Destruye el Rendimiento

Antes de ver las estrategias, vale la pena entender qué ocurre internamente en cada base de datos cuando paginas:

El Problema del OFFSET Profundo

1
2
3
4
-- SQL Server: página 5000 con 20 ítems por página
SELECT Id, Nome, Valor FROM Pedidos
ORDER BY DataCriacao
OFFSET 99980 ROWS FETCH NEXT 20 ROWS ONLY;

La base de datos no “salta” mágicamente a la fila 99.981. Necesita:

  1. Ordenar (o usar el índice de ordenamiento)
  2. Recorrer 99.980 filas y descartarlas
  3. Devolver las 20 siguientes

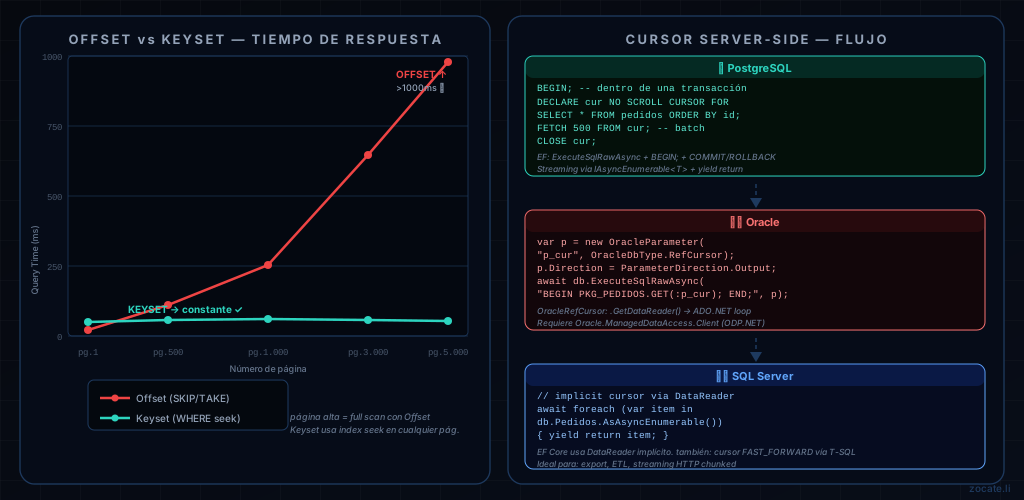
El costo crece linealmente con el offset. Para OFFSET 0 el costo es casi cero; para OFFSET 1.000.000 el costo puede ser de segundos. Este es el problema de la paginación tardía, y aparece en cualquier base de datos.

Por Qué el Ordenamiento Estable Es Obligatorio

1
2
3
4
5
6
7
8
9
// ❌ SIN OrderBy — resultado no determinista
var dados = await context.Pedidos.Skip(40).Take(20).ToListAsync();

// ✅ CON OrderBy — resultado determinista + se puede usar el índice
var dados = await context.Pedidos
    .OrderBy(p => p.DataCriacao)
    .ThenBy(p => p.Id)        // El desempate por el campo único garantiza estabilidad
    .Skip(40).Take(20)
    .ToListAsync();

Sin OrderBy, la base de datos puede devolver los 20 ítems en cualquier orden, y corres el riesgo de ver los mismos registros en páginas distintas o de saltarte registros. Esto es especialmente crítico en Oracle, que por defecto tiene un comportamiento de ordenamiento menos predecible que SQL Server.


Estrategia 1: Offset Pagination (SKIP / TAKE)

Cuándo Usar

  • Interfaces con números de página visibles (página 1, 2, 3…)
  • Reportes que requieren totales exactos
  • Volúmenes pequeños o medianos (hasta ~100 mil registros en la tabla)
  • Cuando el usuario necesita saltar directamente a cualquier página

El SQL de Cada Base de Datos

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
-- SQL Server (2012+)
SELECT Id, ClienteId, Valor, DataCriacao
FROM Pedidos
ORDER BY DataCriacao, Id
OFFSET 40 ROWS FETCH NEXT 20 ROWS ONLY;

-- Oracle 12c+
SELECT Id, ClienteId, Valor, DataCriacao
FROM Pedidos
ORDER BY DataCriacao, Id
OFFSET 40 ROWS FETCH NEXT 20 ROWS ONLY;

-- Oracle 11g (sin soporte nativo — workaround con ROW_NUMBER)
SELECT * FROM (
    SELECT p.*, ROWNUM AS rn
    FROM (
        SELECT Id, ClienteId, Valor, DataCriacao
        FROM Pedidos
        ORDER BY DataCriacao, Id
    ) p
    WHERE ROWNUM <= 60
)
WHERE rn > 40;

-- PostgreSQL
SELECT Id, ClienteId, Valor, DataCriacao
FROM Pedidos
ORDER BY DataCriacao, Id
LIMIT 20 OFFSET 40;

💡 Consejo: El provider Oracle.EntityFrameworkCore detecta automáticamente la versión de Oracle y genera la sintaxis correcta (con FETCH FIRST para 12c+ o ROWNUM para 11g). No necesitas escribir SQL raw para eso.

Implementación con EF Core 8

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
// Models reutilizables para toda la API
public record PaginacaoRequest(
    int Pagina      = 1,
    int TamanhoPagina = 20)
{
    public int TamanhoSeguro => Math.Clamp(TamanhoPagina, 1, 100);
    public int OffsetSeguro  => (Math.Max(Pagina, 1) - 1) * TamanhoSeguro;
}

public record PaginaResultado<T>(
    IReadOnlyList<T>  Dados,
    int               PaginaAtual,
    int               TamanhoPagina,
    long              TotalRegistros,
    int               TotalPaginas,
    bool              TemProxima,
    bool              TemAnterior);

public class PedidoOffsetService(AppDbContext context)
{
    public async Task<PaginaResultado<PedidoDto>> ListarAsync(
        PaginacaoRequest req,
        CancellationToken ct = default)
    {
        var query = context.Pedidos
            .AsNoTracking()
            .OrderBy(p => p.DataCriacao)
            .ThenBy(p => p.Id);

        // EF Core 8: ExecuteCount() separado sin materializar la colección
        var total = await query.LongCountAsync(ct);

        var dados = await query
            .Skip(req.OffsetSeguro)
            .Take(req.TamanhoSeguro)
            .Select(p => new PedidoDto(p.Id, p.ClienteId, p.Valor, p.DataCriacao, p.Status))
            .ToListAsync(ct);

        var totalPaginas = (int)Math.Ceiling(total / (double)req.TamanhoSeguro);

        return new PaginaResultado<PedidoDto>(
            Dados:          dados,
            PaginaAtual:    req.Pagina,
            TamanhoPagina:  req.TamanhoSeguro,
            TotalRegistros: total,
            TotalPaginas:   totalPaginas,
            TemProxima:     req.Pagina < totalPaginas,
            TemAnterior:    req.Pagina > 1);
    }
}

⚠️ Atención: Para tablas con más de 500 mil filas, LongCountAsync() por sí solo puede ser lento (table scan). Una estrategia común es cachear el total durante 30–60 segundos, o usar una columna de conteo materializada.


Estrategia 2: Keyset Pagination (Seek / WHERE-based)

Cuándo Usar

  • APIs REST con scroll infinito o token de “siguiente página”
  • Tablas con millones de registros donde el OFFSET se degrada
  • Feeds de datos en tiempo real donde se insertan ítems nuevos constantemente
  • Exportación asíncrona de grandes volúmenes

Cómo Funciona

En lugar de decir “salta N filas”, dices “dame los registros después de este punto de referencia”. La base de datos usa el índice directamente para posicionarse en el cursor, sin recorrer los registros anteriores.

1
2
3
4
5
6
-- SQL Server / Oracle 12c+ / PostgreSQL — keyset con clave compuesta
SELECT TOP(21) Id, ClienteId, Valor, DataCriacao
FROM Pedidos
WHERE DataCriacao > '2025-06-01T12:00:00'
   OR (DataCriacao = '2025-06-01T12:00:00' AND Id > 'abc-def-123')
ORDER BY DataCriacao ASC, Id ASC;

El TOP 21 (o LIMIT 21) es intencional: se busca un registro extra para saber si existe una página siguiente, sin ejecutar un COUNT.

Índice Obligatorio para Keyset

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
-- SQL Server — índice covering para la query de keyset
CREATE INDEX IX_Pedidos_Keyset
    ON Pedidos (DataCriacao ASC, Id ASC)
    INCLUDE (ClienteId, Valor, Status);

-- Oracle
CREATE INDEX IX_Pedidos_Keyset ON Pedidos (DataCriacao ASC, Id ASC);

-- PostgreSQL
CREATE INDEX IX_Pedidos_Keyset ON Pedidos (DataCriacao ASC, Id ASC)
    INCLUDE (ClienteId, Valor, Status);

Sin este índice, la base de datos vuelve a hacer un full scan incluso con el WHERE de keyset.

Implementación con EF Core 8

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
// Token de cursor — serializado en Base64 para el cliente (opaco)
public record KeysetCursor(Guid UltimoId, DateTime UltimaData)
{
    public string Encode() =>
        Convert.ToBase64String(
            JsonSerializer.SerializeToUtf8Bytes(this));

    public static KeysetCursor? Decode(string? token)
    {
        if (string.IsNullOrEmpty(token)) return null;
        try
        {
            return JsonSerializer.Deserialize<KeysetCursor>(
                Convert.FromBase64String(token));
        }
        catch { return null; }
    }
}

public record KeysetResultado<T>(
    IReadOnlyList<T> Dados,
    bool             TemProximaPagina,
    string?          ProximoToken);   // Token opaco para el cliente

public class PedidoKeysetService(AppDbContext context)
{
    public async Task<KeysetResultado<PedidoDto>> ListarAsync(
        string?           token,
        int               limite   = 20,
        CancellationToken ct       = default)
    {
        limite = Math.Clamp(limite, 1, 100);
        var cursor = KeysetCursor.Decode(token);

        // Expresión de keyset — funciona sin cursor (primera página)
        // y con cursor (páginas siguientes)
        var query = context.Pedidos
            .AsNoTracking()
            .Where(p =>
                cursor == null ||
                p.DataCriacao > cursor.UltimaData ||
                (p.DataCriacao == cursor.UltimaData &&
                 p.Id.CompareTo(cursor.UltimoId) > 0))
            .OrderBy(p => p.DataCriacao)
            .ThenBy(p => p.Id)
            .Select(p => new PedidoDto(p.Id, p.ClienteId, p.Valor, p.DataCriacao, p.Status));

        // Busca límite+1 para detectar si hay página siguiente
        var dados = await query.Take(limite + 1).ToListAsync(ct);

        var temProxima = dados.Count > limite;
        if (temProxima) dados.RemoveAt(dados.Count - 1);

        string? proximoToken = null;
        if (temProxima && dados.Count > 0)
        {
            var ultimo = dados[^1];
            proximoToken = new KeysetCursor(ultimo.Id, ultimo.DataCriacao).Encode();
        }

        return new KeysetResultado<PedidoDto>(dados, temProxima, proximoToken);
    }
}

El token generado es opaco para el cliente — no sabe qué contiene, solo lo pasa a la siguiente llamada. Esto permite cambiar la implementación interna sin romper a los clientes.


Estrategia 3: Cursor de Base de Datos (Server-Side Cursor)

Qué Es un Cursor de Base de Datos y Cuándo Usarlo

Un cursor de base de datos es distinto del cursor de keyset. Aquí, la propia base de datos mantiene una posición de lectura abierta entre llamadas. El servidor reserva recursos (memoria, locks o snapshot) para ese conjunto de resultados mientras el cliente obtiene bloques.

Es la estrategia ideal para:

  • Exportaciones largas donde el cliente consume datos en bloques durante segundos o minutos
  • Procesamiento ETL fila por fila sin cargar todo en memoria
  • Streaming de datos vía WebSocket o Server-Sent Events
  • Situaciones en las que el conjunto de resultados no puede cambiar durante la lectura (consistencia de snapshot)

⚠️ Atención: Los cursores de base de datos consumen recursos del servidor mientras están abiertos. En SQL Server y Oracle, los cursores mal gestionados (dejados abiertos) causan presión de memoria e incluso bloqueos. PostgreSQL maneja mejor los cursores dentro de transacciones, pero aun así requiere cuidado.

PostgreSQL: DECLARE CURSOR (el más completo)

PostgreSQL tiene el soporte más rico para cursores server-side. Para usarlos con EF Core, necesitas ejecutar SQL raw dentro de una transacción, porque los cursores de PostgreSQL solo existen dentro del alcance de una transacción:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
// dotnet add package Npgsql.EntityFrameworkCore.PostgreSQL
public class PedidoCursorService(AppDbContext context)
{
    public async IAsyncEnumerable<PedidoDto> StreamAsync(
        int blocoPorFetch = 500,
        [EnumeratorCancellation] CancellationToken ct = default)
    {
        // El cursor PG exige una transacción activa durante toda la lectura
        await using var transaction = await context.Database
            .BeginTransactionAsync(ct);

        // DECLARE abre el cursor en el servidor
        await context.Database.ExecuteSqlRawAsync(
            "DECLARE pedidos_cursor NO SCROLL CURSOR FOR " +
            "SELECT p.\"Id\", p.\"ClienteId\", p.\"Valor\", p.\"DataCriacao\", p.\"Status\" " +
            "FROM \"Pedidos\" p ORDER BY p.\"DataCriacao\", p.\"Id\"",
            ct);

        try
        {
            while (!ct.IsCancellationRequested)
            {
                // FETCH obtiene un bloque a la vez — nunca todo en memoria
                var bloco = await context.Database
                    .SqlQueryRaw<PedidoDto>(
                        $"FETCH {blocoPorFetch} FROM pedidos_cursor")
                    .ToListAsync(ct);

                if (bloco.Count == 0) break;   // Fin del cursor

                foreach (var item in bloco)
                    yield return item;

                if (bloco.Count < blocoPorFetch) break; // Último bloque parcial
            }
        }
        finally
        {
            // CLOSE libera recursos en el servidor — SIEMPRE ejecutar
            await context.Database.ExecuteSqlRawAsync(
                "CLOSE pedidos_cursor", CancellationToken.None);

            await transaction.CommitAsync(CancellationToken.None);
        }
    }
}

SQL Server: Cursor FAST_FORWARD vía SQL Raw

SQL Server soporta cursores T-SQL, pero para APIs REST el patrón más eficiente es usar IAsyncEnumerable con AsAsyncEnumerable() de EF Core o un cursor vía ADO.NET directamente:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
// SQL Server: streaming con IAsyncEnumerable de EF Core 8
// Internamente usa un DataReader que consume fila por fila
public class PedidoStreamService(AppDbContext context)
{
    public async IAsyncEnumerable<PedidoDto> StreamComEfCoreAsync(
        DateTime? dataInicio = null,
        [EnumeratorCancellation] CancellationToken ct = default)
    {
        // AsAsyncEnumerable() no materializa la colección —
        // mantiene el DataReader abierto y lee bajo demanda
        var query = context.Pedidos
            .AsNoTracking()
            .Where(p => dataInicio == null || p.DataCriacao >= dataInicio)
            .OrderBy(p => p.DataCriacao)
            .ThenBy(p => p.Id)
            .Select(p => new PedidoDto(p.Id, p.ClienteId, p.Valor, p.DataCriacao, p.Status));

        await foreach (var item in query.AsAsyncEnumerable().WithCancellation(ct))
        {
            yield return item;
        }
    }
}

💡 Consejo: AsAsyncEnumerable() en EF Core se implementa como un DataReader que permanece abierto mientras se consume el IAsyncEnumerable. Internamente funciona como un cursor de base de datos implícito. La diferencia con un cursor SQL explícito es que el DataReader no permite pausar la lectura y retomarla más tarde en una nueva conexión.

Oracle: REF CURSOR y SYS_REFCURSOR

En Oracle, el equivalente es el REF CURSOR, normalmente expuesto mediante una stored procedure. Con el provider Oracle.EntityFrameworkCore, puedes ejecutarlo así:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
// Oracle: REF CURSOR vía stored procedure
// La procedure devuelve un SYS_REFCURSOR como parámetro OUT
public class PedidoOracleService(AppDbContext context)
{
    public async Task<List<PedidoDto>> BuscarViaCursorAsync(
        DateTime dataInicio,
        int quantidade,
        CancellationToken ct = default)
    {
        var param_dataInicio = new OracleParameter("p_data",   OracleDbType.Date)
            { Value = dataInicio };
        var param_qtd        = new OracleParameter("p_qtd",    OracleDbType.Int32)
            { Value = quantidade };
        var param_cursor     = new OracleParameter("p_cursor", OracleDbType.RefCursor)
            { Direction = ParameterDirection.Output };

        // Llama a la stored procedure que hace OPEN cursor FOR SELECT ...
        await context.Database.ExecuteSqlRawAsync(
            "BEGIN PKG_PEDIDOS.BUSCAR_PAGINADO(:p_data, :p_qtd, :p_cursor); END;",
            param_dataInicio, param_qtd, param_cursor, ct);

        // Lee el REF CURSOR devuelto por Oracle
        var refCursor = (OracleRefCursor)param_cursor.Value;
        using var reader = refCursor.GetDataReader();

        var resultado = new List<PedidoDto>();
        while (await reader.ReadAsync(ct))
        {
            resultado.Add(new PedidoDto(
                Id:          reader.GetGuid(0),
                ClienteId:   reader.GetString(1),
                Valor:       reader.GetDecimal(2),
                DataCriacao: reader.GetDateTime(3),
                Status:      reader.GetString(4)));
        }
        return resultado;
    }
}

Estrategia 4: Time-based Pagination

Cuándo Usar

  • Datos con dimensión temporal natural (logs, eventos, transacciones)
  • APIs de auditoría o historial con filtros de ventana de tiempo
  • Cuando el cliente quiere datos de una hora específica (ej.: “pedidos de ayer”)
  • Integración con sistemas de streaming (Kafka, Event Sourcing)

Implementación

La paginación time-based es una forma especializada de keyset, con la columna de fecha como cursor principal. La diferencia es que el cliente elige la ventana de tiempo explícitamente:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
public record TimePaginacaoRequest(
    DateTime  DataInicio,
    DateTime  DataFim,
    DateTime? UltimaDataVista = null,  // Cursor dentro de la ventana
    Guid?     UltimoIdVisto   = null,
    int       Limite          = 50);

public class PedidoTimeService(AppDbContext context)
{
    public async Task<KeysetResultado<PedidoDto>> ListarPorJanelaAsync(
        TimePaginacaoRequest req,
        CancellationToken    ct = default)
    {
        var limite = Math.Clamp(req.Limite, 1, 200);

        var query = context.Pedidos
            .AsNoTracking()
            // Ventana de tiempo fija — mantiene el conjunto estable
            .Where(p => p.DataCriacao >= req.DataInicio &&
                        p.DataCriacao <  req.DataFim)
            // Cursor dentro de la ventana (para paginación secuencial)
            .Where(p =>
                req.UltimaDataVista == null ||
                p.DataCriacao > req.UltimaDataVista ||
                (p.DataCriacao == req.UltimaDataVista &&
                 p.Id.CompareTo(req.UltimoIdVisto!.Value) > 0))
            .OrderBy(p => p.DataCriacao)
            .ThenBy(p => p.Id)
            .Select(p => new PedidoDto(p.Id, p.ClienteId, p.Valor, p.DataCriacao, p.Status));

        var dados = await query.Take(limite + 1).ToListAsync(ct);
        var temProxima = dados.Count > limite;
        if (temProxima) dados.RemoveAt(dados.Count - 1);

        string? proximoToken = null;
        if (temProxima && dados.Count > 0)
        {
            var ultimo = dados[^1];
            proximoToken = new KeysetCursor(ultimo.Id, ultimo.DataCriacao).Encode();
        }

        return new KeysetResultado<PedidoDto>(dados, temProxima, proximoToken);
    }
}

💡 Consejo: La gran ventaja de la paginación time-based frente al keyset puro es que el cliente puede elegir ventanas inmutables (ej.: “todo el día 2025-01-01”), lo que permite cachear agresivamente esas ventanas en el servidor, ya que el contenido no cambia después de que la ventana se cierra.


Estrategia 5: Token Opaco y Enlaces HATEOAS

Cuándo Usar

  • APIs públicas donde no quieres exponer detalles de implementación al cliente
  • Cuando la estrategia de paginación puede cambiar sin romper a los clientes
  • APIs que necesitan HATEOAS (enlaces de página siguiente/anterior en la respuesta)

El token opaco encapsula internamente cualquier estrategia de cursor:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
// Respuesta en el patrón HATEOAS con enlaces de navegación
public record PaginacaoHateoasResultado<T>(
    IReadOnlyList<T> Dados,
    PaginacaoLinks   Links,
    PaginacaoMeta    Meta);

public record PaginacaoLinks(
    string?  Primeiro,
    string?  Anterior,
    string?  Proximo,
    string?  Ultimo);

public record PaginacaoMeta(
    int  Limite,
    long TotalRegistros,
    bool TemProxima);

// Endpoint que arma la respuesta HATEOAS
app.MapGet("/api/v1/pedidos", async (
    HttpContext          httpCtx,
    [FromQuery] string?  cursor,
    [FromQuery] int      limite = 20,
    PedidoKeysetService  service,
    CancellationToken    ct) =>
{
    var resultado = await service.ListarAsync(cursor, limite, ct);
    var baseUrl   = $"{httpCtx.Request.Scheme}://{httpCtx.Request.Host}/api/v1/pedidos";

    return Results.Ok(new PaginacaoHateoasResultado<PedidoDto>(
        Dados:  resultado.Dados,
        Links:  new PaginacaoLinks(
            Primeiro:  $"{baseUrl}?limite={limite}",
            Anterior:  null,  // Keyset no permite volver sin historial
            Proximo:   resultado.TemProximaPagina
                           ? $"{baseUrl}?cursor={resultado.ProximoToken}&limite={limite}"
                           : null,
            Ultimo:    null),
        Meta: new PaginacaoMeta(
            Limite:          limite,
            TotalRegistros:  -1,  // Keyset no calcula el total
            TemProxima:      resultado.TemProximaPagina)));
});

Comparativo: Qué Estrategia Usar en Cada Situación

CriterioOffsetKeyset / SeekCursor Server-SideTime-basedToken Opaco
Total de registros✅ Sí❌ No❌ No⚠️ Por ventana❌ No
Saltar páginas✅ Directo❌ Solo secuencial❌ Solo secuencial✅ Por ventana❌ Solo secuencial
Rendimiento en páginas tardías❌ Se degrada✅ Constante✅ Constante✅ Constante✅ Constante
Registros nuevos entre páginas❌ Drift✅ Consistente✅ Snapshot✅ Ventana fija✅ Consistente
Complejidad de implementación⭐ Simple⭐⭐ Media⭐⭐⭐ Alta⭐⭐ Media⭐⭐ Media
Recursos del servidorBajoBajo🔴 Alto (cursor abierto)BajoBajo
Soporte nativo EF Core✅ Completo✅ Con Where personalizado⚠️ SQL Raw / ADO✅ Con Where personalizado✅ Sobre keyset
SQL Server✅ OFFSET FETCH✅ WHERE seek✅ Cursor FAST_FORWARD✅ WHERE range✅
Oracle✅ 12c+ / ROWNUM 11g✅ WHERE seek✅ REF CURSOR✅ WHERE range✅
PostgreSQL✅ LIMIT OFFSET✅ WHERE seek✅ DECLARE CURSOR✅ WHERE range✅
Ideal paraUI clásicaAPIs / mobileETL / streamingAuditoría / logsAPIs públicas

Comparativo de estrategias: Offset vs Keyset (gráfico de rendimiento) y flujo de Cursor Server-Side en las tres bases de datos


Índices: La Base de Toda Paginación

Ninguna estrategia de paginación funciona bien sin los índices correctos. Para cada base de datos:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
-- ============================================
-- SQL Server — Índices para paginación
-- ============================================

-- Para Offset por DataCriacao
CREATE INDEX IX_Pedidos_DataCriacao
    ON Pedidos (DataCriacao ASC, Id ASC)
    INCLUDE (ClienteId, Valor, Status);

-- Para filtros frecuentes + paginación
CREATE INDEX IX_Pedidos_ClienteId_Data
    ON Pedidos (ClienteId ASC, DataCriacao ASC, Id ASC)
    INCLUDE (Valor, Status);

-- ============================================
-- Oracle — Equivalentes
-- ============================================
CREATE INDEX IX_Pedidos_DataCriacao
    ON Pedidos (DataCriacao ASC, Id ASC);

-- Oracle: statistics importantes para el optimizador
EXECUTE DBMS_STATS.GATHER_TABLE_STATS('SCHEMA', 'PEDIDOS');

-- ============================================
-- PostgreSQL — Con partial index opcional
-- ============================================
CREATE INDEX IX_Pedidos_DataCriacao
    ON Pedidos (DataCriacao ASC, Id ASC)
    INCLUDE (ClienteId, Valor, Status);

-- Partial index para status frecuente (ej.: solo pedidos activos)
CREATE INDEX IX_Pedidos_Ativos
    ON Pedidos (DataCriacao ASC, Id ASC)
    WHERE Status = 'Ativo';

⚠️ Atención Oracle: Oracle no soporta columnas INCLUDE en índices regulares (a diferencia de SQL Server y PostgreSQL). Para índices covering en Oracle, usa Composite Indexes o Index-Organized Tables (IOT) en tablas con alto volumen de lectura.


Middleware de Paginación Reutilizable para ASP.NET Core

Para APIs REST con múltiples endpoints, crear un middleware de paginación evita la duplicación:

 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
// Extensions para registrar los servicios y configurar la respuesta predeterminada
public static class PaginacaoExtensions
{
    // Header estándar de paginación (común en APIs REST)
    public static IEndpointConventionBuilder ComPaginacao(
        this IEndpointConventionBuilder builder)
    {
        // Agrega headers de documentación en OpenAPI
        builder.WithOpenApi(op =>
        {
            op.Parameters.Add(new OpenApiParameter
            {
                Name     = "cursor",
                In       = ParameterLocation.Query,
                Required = false,
                Schema   = new OpenApiSchema { Type = "string" },
                Description = "Token de cursor para la página siguiente (keyset pagination)"
            });
            op.Parameters.Add(new OpenApiParameter
            {
                Name     = "limite",
                In       = ParameterLocation.Query,
                Required = false,
                Schema   = new OpenApiSchema { Type = "integer", Default = new OpenApiInteger(20) }
            });
            return op;
        });
        return builder;
    }

    // Agrega el header HTTP Link estándar RFC 5988
    public static void AdicionarLinkHeader<T>(
        this HttpContext ctx,
        KeysetResultado<T> resultado,
        string baseUrl)
    {
        if (resultado.ProximoToken != null)
            ctx.Response.Headers.Append(
                "Link",
                $"<{baseUrl}?cursor={resultado.ProximoToken}>; rel=\"next\"");
    }
}

Consejos y Buenas Prácticas

  • Nunca devuelvas sin Take/Limit: Aplica siempre un límite máximo en la capa de servicio, independientemente de lo que envió el cliente. Exponlo mediante la validación de la solicitud.
  • Keyset requiere una clave compuesta estable: Usa siempre (columna_ordenamiento, id_unico) como cursor compuesto. La columna de ordenamiento sola puede tener duplicados; el Id garantiza unicidad y estabilidad.
  • Cursor de base de datos: ciérralo siempre: Para cursores server-side (DECLARE de PostgreSQL, REF CURSOR de Oracle), usa try/finally para garantizar el CLOSE. Un cursor abierto en Oracle o SQL Server consume recursos del servidor indefinidamente.
  • Documenta el tipo de paginación en OpenAPI: Indica en Swagger qué estrategia usa cada endpoint — los clientes necesitan saber si pueden saltar páginas o solo avanzar secuencialmente.
  • Versiona la estrategia de paginación: Si cambias de Offset a Keyset en un endpoint existente, versiona la API (/v2/pedidos) para no romper a los clientes que dependen del campo totalPaginas.
  • Monitorea las consultas lentas: Habilita Query Store (SQL Server), AWR (Oracle) o pg_stat_statements (PostgreSQL) para capturar consultas de paginación que superen los SLAs.
  • Prefiere proyecciones con Select(): Nunca devuelvas la entidad completa en endpoints de listado. Selecciona solo los campos necesarios para reducir I/O y asignación de memoria.

Conclusión

Paginar datos en APIs REST con C# y EF Core 8 va mucho más allá de .Skip().Take(). Cada estrategia — Offset, Keyset, Cursor server-side, Time-based y Token opaco — existe por una razón y atiende escenarios distintos. La elección equivocada resulta en consultas lentas, inconsistencias de datos o consumo innecesario de recursos de la base de datos.

El camino más seguro es: empezar con Offset para interfaces simples con volúmenes controlados, migrar a Keyset cuando la tabla crezca y el offset empiece a degradarse, usar Cursor server-side solo para streaming y ETL con una gestión cuidadosa del ciclo de vida, y Time-based para datos con dimensión temporal natural.

SQL Server, Oracle y PostgreSQL soportan todas estas estrategias — las diferencias están en la sintaxis y en los detalles de implementación, pero EF Core 8 abstrae la mayoría de ellas. Lo que EF Core no hace por ti es crear los índices correctos: eso siempre es tu responsabilidad.

Si llegaste hasta aquí buscando entender cómo los cuellos de botella de la base de datos afectan no solo la lectura sino también la escritura masiva, continúa con el artículo Cuello de Botella en Bases de Datos: Mensajería y Paginación, que cubre la solución con mensajería (RabbitMQ y Azure Service Bus) para el lado de la escritura.


Lee También


Referencias