Introducción
Si trabajas con tecnología, ya te habrás dado cuenta: cada día surge una sigla nueva en el universo de la inteligencia artificial. LLM, RAG, MCP, Agent, Skill, Modelo — la lista crece más rápido de lo que cualquier profesional puede seguir. Y lo peor no es la cantidad de términos. Lo peor es que esos términos aparecen en reuniones, en decisiones de arquitectura, en descripciones de vacantes y en roadmaps de producto — y muchas veces nadie se detiene a explicar qué significa realmente cada uno.
Este artículo existe para resolver eso. Fue escrito para profesionales de TI que ya tienen experiencia en desarrollo, infraestructura o gestión, pero que no han tenido tiempo (u oportunidad) de sumergirse en los conceptos fundamentales de la IA moderna. No es un tutorial de implementación. Es un mapa conceptual — una referencia que puedes consultar cuando necesites entender qué es cada pieza y cómo encajan entre sí.
Al final de la lectura, vas a entender:
- Qué es la IA y cómo se divide en capas (Machine Learning, Deep Learning, IA Generativa)
- Qué es un Modelo de IA y qué significa tener 7 mil millones o 405 mil millones de parámetros
- Qué es un LLM y por qué es el motor detrás de herramientas como ChatGPT, Copilot y Claude
- Qué es RAG y por qué resuelve uno de los mayores problemas de los LLMs
- Qué es un Agente de IA y en qué se diferencia de un chatbot
- Qué es una Skill y en qué se diferencia de una herramienta
- Qué es MCP y por qué lo llaman “el USB de la inteligencia artificial”
- Quiénes son los principales actores del mercado y en qué destaca cada uno
Vamos directo al grano.
Requisitos previos
- Familiaridad básica con desarrollo de software o infraestructura de TI
- No se necesita ningún conocimiento previo de IA — el artículo parte de cero
Qué es la Inteligencia Artificial
La Inteligencia Artificial (IA) es un campo de la ciencia de la computación dedicado a crear sistemas capaces de realizar tareas que normalmente requerirían inteligencia humana. Reconocer patrones en imágenes, entender lenguaje natural, tomar decisiones basadas en datos, generar texto y código — todo eso cabe bajo el paraguas de la IA.
Pero IA es un término amplio. Piensa en él como una muñeca rusa — dentro de él existen subáreas progresivamente más específicas:
| |
- Machine Learning (ML): Sistemas que aprenden a partir de datos, sin ser programados explícitamente para cada situación. Ejemplo: un modelo de detección de fraudes que aprende patrones a partir de transacciones históricas.
- Deep Learning (DL): Subconjunto del ML que usa redes neuronales con muchas capas (“profundas”). Es la base de los avances recientes en reconocimiento de imagen, voz y lenguaje.
- IA Generativa (GenAI): Subconjunto del Deep Learning especializado en crear contenido nuevo — texto, imagen, código, audio, video. Aquí es donde viven ChatGPT, Copilot, Claude y Gemini.
💡 Consejo: Cuando alguien dice “IA” en el contexto corporativo actual, la mayoría de las veces se refiere a la IA Generativa — específicamente a los modelos de lenguaje (LLMs). Es importante saber que la IA es mucho más que eso, pero el hype del momento se concentra en esta capa.
La diferencia práctica entre la IA tradicional y la IA moderna es simple: la IA tradicional funciona con reglas predefinidas (si X, entonces Y). La IA moderna aprende patrones a partir de datos y generaliza a situaciones que nunca ha visto. Ambos enfoques coexisten — y cada uno tiene su lugar.
Qué es un Modelo de IA
Cuando alguien menciona un “modelo” en el contexto de la IA, está hablando de un artefacto matemático que fue entrenado con datos para reconocer patrones y hacer predicciones. En la práctica, un modelo es un archivo (o conjunto de archivos) que contiene pesos — números que se ajustaron durante el proceso de entrenamiento para que el modelo produzca respuestas útiles.
Una analogía que funciona bien: piensa en el modelo como un cerebro entrenado para una tarea específica. Así como un radiólogo se entrenó durante años leyendo miles de exámenes para identificar anomalías, un modelo de IA fue “entrenado” procesando millones (o miles de millones) de ejemplos para aprender patrones.
Tipos de modelos
| Tipo | Qué hace | Ejemplos |
|---|---|---|
| Lenguaje | Genera y comprende texto, código, razonamiento | GPT-4o, Claude, Llama |
| Imagen | Genera, edita o clasifica imágenes | DALL-E, Midjourney, Stable Diffusion |
| Audio | Genera voz, transcribe audio, clona voces | Whisper, ElevenLabs, Bark |
| Multimodal | Combina texto, imagen, audio y/o video | GPT-4o, Gemini 2.0, Claude 3.5 |
Qué son los parámetros
Seguramente ya viste referencias como “modelo de 7B” o “modelo de 405B”. La B viene de billions (miles de millones). Los parámetros son los pesos internos del modelo — cuantos más parámetros, mayor la capacidad del modelo para capturar matices y patrones complejos.
ℹ️ Información: Más parámetros no significa necesariamente mejor. Un modelo de 70B bien entrenado y optimizado puede superar a uno de 405B en tareas específicas. Lo que importa es la combinación de arquitectura, datos de entrenamiento, técnica de optimización y alineamiento.
En la práctica, los modelos más grandes (cientos de miles de millones de parámetros) son más caros de ejecutar, más lentos en las respuestas y exigen una infraestructura robusta. Los modelos más pequeños (7B a 14B) pueden ejecutarse localmente en una GPU de consumo y son ideales para tareas específicas cuando se ajustan (fine-tuned) a un dominio.
Entrenamiento vs. Inferencia
- Entrenamiento: El proceso de alimentar el modelo con datos para que aprenda patrones. Es caro, lento y lo hacen grandes empresas (OpenAI, Google, Meta). Puede llevar semanas ejecutándose en miles de GPUs.
- Inferencia: El proceso de usar el modelo ya entrenado para generar respuestas. Es lo que ocurre cuando envías un mensaje a ChatGPT — el modelo hace inferencia para producir la respuesta.
Cuando usas una API de IA (OpenAI, Anthropic, Google), estás pagando por la inferencia. El costo se mide en tokens — unidades de texto procesadas por el modelo.
Qué es un LLM (Large Language Model)
Un LLM (Large Language Model, o Modelo de Lenguaje de Gran Escala) es un tipo específico de modelo de IA entrenado con enormes volúmenes de texto. La idea central es simple: el modelo aprendió a predecir la siguiente palabra (más precisamente, el siguiente token) en una secuencia de texto.
Parece trivial, pero esta capacidad de predecir el siguiente token de forma sofisticada es lo que permite a un LLM:
- Generar texto coherente — artículos, resúmenes, emails, documentación
- Escribir y explicar código — en decenas de lenguajes
- Traducir entre idiomas
- Razonar sobre problemas — análisis lógico, matemáticas, planificación
- Seguir instrucciones — responder preguntas, ejecutar tareas complejas vía prompt
Cómo funciona (simplificado)
Cuando envías una pregunta a un LLM, el modelo no “entiende” la pregunta en el sentido humano. Calcula, con base en los patrones aprendidos durante el entrenamiento, qué secuencia de tokens tiene mayor probabilidad de ser una buena continuación del texto que enviaste.
| |
Por eso los LLMs a veces “alucinan” — es decir, generan información que parece correcta pero es inventada. El modelo está optimizado para generar texto plausible, no necesariamente verdadero. No consulta una base de datos de hechos — genera texto basado en patrones estadísticos.
Limitaciones importantes
| Limitación | Explicación |
|---|---|
| Alucinación | Inventa información con apariencia de verdad. Cita fuentes que no existen, genera datos ficticios. |
| Corte de conocimiento | El modelo solo sabe lo que existía hasta la fecha final del entrenamiento. No tiene acceso a información actual. |
| Sin memoria persistente | Cada conversación empieza de cero (a menos que exista un mecanismo externo de contexto). |
| Sesgo | Refleja los sesgos presentes en los datos de entrenamiento. |
| Ventana de contexto | Hay un límite de tokens que el modelo puede procesar de una vez (4K, 128K, 200K, 1M — varía según el modelo). |
⚠️ Atención: Una de las trampas más comunes para quien empieza a usar LLMs es confiar demasiado en la respuesta. El modelo no “sabe” — genera texto que parece saber. Valida siempre la información crítica con fuentes primarias.
Principales LLMs del mercado
| Modelo | Empresa | Destacados |
|---|---|---|
| GPT-4o, o1, o3 | OpenAI | El más popular, excelente para uso general y código |
| Claude 3.5 Opus/Sonnet | Anthropic | Fuerte en razonamiento largo, seguridad y coding |
| Gemini 2.0 | Multimodal nativo, ventana de contexto enorme | |
| Llama 3.3 | Meta | Líder open-source, ejecutable localmente |
| DeepSeek V3, R1 | DeepSeek | Open-source, excelente relación costo-beneficio |
Qué es RAG (Retrieval-Augmented Generation)
Acabas de aprender que los LLMs tienen un problema fundamental: no conocen tus datos. El modelo se entrenó con datos públicos de internet, libros y código abierto — pero no sabe nada sobre la documentación interna de tu empresa, la wiki de tu equipo, tus contratos, tus logs, tus tickets.
RAG (Retrieval-Augmented Generation, o Generación Aumentada por Recuperación) es la técnica que resuelve este problema sin necesidad de reentrenar el modelo.
Cómo funciona
La idea es elegante: antes de enviar la pregunta al LLM, buscas información relevante en tu base de datos y la inyectas en el prompt como contexto adicional. El modelo genera entonces la respuesta con base en ese contexto — no solo en lo que aprendió durante el entrenamiento.
| |
¿Por qué RAG y no fine-tuning?
| Enfoque | Ventaja | Desventaja |
|---|---|---|
| RAG | Datos siempre actualizados, sin costo de entrenamiento, más transparente | Depende de la calidad de la búsqueda |
| Fine-tuning | El modelo internaliza el conocimiento, menor latencia | Caro, los datos quedan desactualizados, difícil de mantener |
💡 Consejo: Para la mayoría de los casos de uso corporativos, RAG es la primera opción. El fine-tuning solo tiene sentido cuando necesitas que el modelo internalice un estilo o un vocabulario muy específico, o cuando la latencia de búsqueda es inaceptable.
Cuándo usar RAG
- Chatbots corporativos que responden sobre documentación interna
- Asistentes de código que conocen el código base de tu empresa
- Sistemas de soporte que consultan manuales y FAQs
- Cualquier escenario en el que el LLM necesite información que no tiene por defecto
La clave de RAG es la búsqueda vectorial — una técnica que transforma texto en vectores numéricos (embeddings) y encuentra documentos semánticamente similares a la pregunta, aunque usen palabras diferentes.
Qué es un Agente de IA
Un Agente de IA es un LLM con superpoderes: además de generar texto, puede usar herramientas, tomar decisiones y ejecutar acciones de forma autónoma o semiautónoma.
La diferencia entre un chatbot y un agente es la misma que entre alguien que da consejos y alguien que hace que las cosas sucedan:
| Chatbot (LLM puro) | Agente de IA |
|---|---|
| “Deberías crear una rama y abrir un PR.” | Crea la rama, escribe el código, abre el PR y pide tu revisión. |
| “La query SQL para eso sería SELECT…” | Ejecuta la query, analiza los resultados y presenta un informe. |
| “Puedes corregir el bug cambiando la línea 42.” | Cambia la línea 42, ejecuta los tests, confirma que pasan y hace el commit. |
El ciclo de un Agente
Un agente de IA funciona en un ciclo continuo:
| |
Ejemplos reales de Agentes
- GitHub Copilot Coding Agent: Recibe una issue, crea una rama, implementa la solución, ejecuta tests y abre un PR — todo automáticamente.
- Agentes de CI/CD: Analizan fallos en pipelines, identifican la causa raíz y sugieren (o aplican) correcciones.
- Agentes de investigación: Reciben una pregunta compleja, buscan en múltiples fuentes, sintetizan y entregan un informe consolidado.
- Agentes de datos: Reciben una pregunta en lenguaje natural, la traducen a SQL, la ejecutan, analizan y presentan resultados visuales.
⚠️ Atención: Los agentes son poderosos, pero traen riesgos. Un agente con permisos para ejecutar comandos en la terminal puede causar daños reales si está mal configurado. La autonomía sin supervisión es el principal riesgo. Por eso, patrones como human-in-the-loop (aprobación humana antes de acciones críticas) son fundamentales en entornos de producción.
Qué necesita un Agente
Para funcionar, un agente necesita:
- Un LLM como “cerebro” (GPT-4o, Claude, Gemini, etc.)
- Herramientas que pueda invocar (APIs, CLI, buscadores, bases de datos)
- Contexto (instrucciones, documentación, historial de la conversación)
- Permisos controlados (qué puede y qué no puede hacer)
- Un protocolo para conectarlo todo (aquí es donde entra MCP — que veremos más adelante)
Qué es una Skill
En el ecosistema de agentes, una Skill (habilidad) es un bloque de conocimiento o de instrucciones especializadas que un agente puede consultar para realizar una tarea con más precisión.
Piénsalo así: si el agente es un profesional generalista, la skill es el manual de referencia que consulta cuando necesita conocimiento específico sobre un dominio.
Skill vs. Tool — ¿cuál es la diferencia?
Esta distinción es importante porque los dos términos aparecen con frecuencia juntos:
| Concepto | Qué es | Analogía |
|---|---|---|
| Skill | Conocimiento, instrucciones, buenas prácticas | Un manual de referencia, una guía de estilo |
| Tool | Una acción que el agente puede ejecutar | Un martillo, un destornillador, una API |
Un ejemplo concreto en GitHub Copilot:
- Una Skill de deploy en Azure contiene instrucciones sobre cómo estructurar archivos Bicep, qué convenciones seguir y qué errores evitar. El agente lee esas instrucciones para tomar mejores decisiones.
- Una Tool de terminal permite que el agente ejecute comandos en el shell. Puede usar la skill de Azure para saber qué ejecutar y la tool de terminal para ejecutarlo de hecho.
Ejemplos de Skills
- Instrucciones de un proyecto: Un archivo
.instructions.mdque enseña a Copilot las convenciones de tu repositorio (estilo de commit, estructura de directorios, patrones de código). - Dominios especializados: Skills de seguridad (
azure-security), de deploy (azure-deploy), de evaluación de agentes (evaluation). - Conocimiento corporativo: Reglas de negocio, políticas de compliance y estándares de arquitectura internos que el agente debe seguir.
💡 Consejo: Las skills son la forma más accesible de personalizar un agente sin cambiar el modelo. En lugar de fine-tuning (caro y complejo), escribes instrucciones claras y el agente las sigue. Es la diferencia entre entrenar a un empleado nuevo desde cero y entregarle un manual bien escrito para consultar.
Qué es MCP (Model Context Protocol)
El Model Context Protocol (MCP) es un protocolo abierto creado por Anthropic que estandariza la forma en que los modelos de IA se conectan a herramientas, datos y servicios externos.
El problema que MCP resuelve
Antes de MCP, cada herramienta de IA tenía su propia forma de integración. Si querías que Claude accediera a tu base de datos, necesitabas una integración específica para Claude. Si querías que GPT accediera a la misma base, necesitabas otra integración. Era como si cada fabricante de electrónica tuviera su propio tipo de conector — sin estándar, sin interoperabilidad.
La analogía del USB
MCP hace por la IA lo que el USB hizo por los dispositivos electrónicos: define un estándar universal de conexión.
| |
Con MCP, creas un servidor que expone las herramientas, y cualquier cliente compatible con MCP puede usarlo. Desarrolla una vez, conecta en cualquier lugar.
Componentes de MCP
| Componente | Función | Ejemplo |
|---|---|---|
| MCP Server | Expone herramientas y datos mediante un protocolo estandarizado | Un server que da acceso a las issues de GitHub |
| MCP Client | Consume las herramientas expuestas por el server | VS Code, Claude Desktop, Cursor |
| Protocolo | Comunicación JSON-RPC entre client y server | Basado en JSON-RPC 2.0 |
Ejemplo práctico
Imagina que tu empresa crea un MCP Server que expone:
- Consulta de tickets en Jira
- Búsqueda en la documentación interna (wiki)
- Lectura de métricas de Grafana
Una vez que ese MCP Server existe, cualquier agente de IA compatible con MCP puede usar esas herramientas — ya sea Copilot en VS Code, Claude Desktop o un agente personalizado de tu empresa.
Quién lo está adoptando
MCP fue creado por Anthropic, pero su rápida adopción sorprendió incluso a sus creadores:
- Microsoft: Integró MCP en VS Code, GitHub Copilot y Azure AI
- Google: Soporte en Gemini y en las herramientas de Google Cloud
- Cursor: Soporte nativo para MCP Servers
- Comunidad: Cientos de MCP servers open-source (GitHub, Postgres, Slack, Notion, etc.)
ℹ️ Información: MCP es open-source y la especificación está disponible públicamente. Cualquiera puede crear un MCP Server para exponer herramientas y datos, o un MCP Client para consumirlos. Eso es lo que hace tan poderoso al protocolo — es un estándar abierto, no propietario.
Principales Actores de IA en el Mercado
Ahora que entiendes los conceptos, vamos a mapear quién hace qué en el ecosistema de IA. Cada empresa tiene puntos fuertes diferentes — saberlo ayuda a elegir la herramienta adecuada para cada escenario.
| Actor | Principales Modelos | Destacado | Modelo de negocio |
|---|---|---|---|
| OpenAI | GPT-4o, o1, o3, DALL-E | Pionera del hype de la IA generativa. ChatGPT es el producto de IA más popular del mundo. Fuerte en generación de código y uso general. | API de pago (por token), ChatGPT Plus ($20/mes) |
| Anthropic | Claude Opus, Sonnet, Haiku | Foco en seguridad y alineamiento. Claude destaca en razonamiento largo, análisis de documentos extensos y coding. Creadora de MCP. | API de pago, Claude Pro ($20/mes) |
| Gemini 2.0, Gemma | Multimodal nativo (texto + imagen + video + audio). Ventana de contexto enorme (hasta 2M tokens). Integración con el ecosistema Google. | API de pago, Gemini Advanced ($20/mes) | |
| Meta | Llama 3.1, 3.3, 4 | Líder en modelos open-source. Llama se puede descargar y ejecutar localmente, sin depender de una API. Ideal para quien quiere control total. | Open-source (gratuito para uso) |
| Microsoft | Copilot, Azure OpenAI | No crea modelos propios (usa OpenAI), pero lidera la integración enterprise. Copilot está en VS Code, GitHub, Office 365 y Azure. | Licencias corporativas, Azure pay-as-you-go |
| DeepSeek | DeepSeek V3, R1 | Empresa china que sorprendió con modelos open-source de altísima calidad a un costo muy bajo. Destaca en razonamiento y código. | Open-source + API a precios muy agresivos |
| Mistral | Mistral Large, Codestral | Empresa francesa. Modelos open-weight con foco en eficiencia. Buen equilibrio entre calidad y costo. Fuerte en código. | Open-weight + API de pago |
| xAI | Grok 2, Grok 3 | Empresa de Elon Musk. Integrada en X (antes Twitter). Foco en razonamiento y análisis en tiempo real. | API de pago, integrada en X Premium |
| Amazon | Nova, Bedrock | Amazon Bedrock es un hub multimodelo (accede a Claude, Llama y Mistral mediante la misma API). Nova es el modelo propio de Amazon. | AWS pay-as-you-go |
Cómo elegir
La elección del actor (y del modelo) depende de tu escenario:
- Uso general y productividad: OpenAI (ChatGPT) o Google (Gemini) — los más accesibles y versátiles.
- Desarrollo de software: Anthropic (Claude Sonnet) u OpenAI (GPT-4o) — dominan en coding y razonamiento técnico.
- Privacidad y control: Meta (Llama) o Mistral — modelos open-source que se ejecutan en tu infraestructura.
- Costo agresivo: DeepSeek — calidad competitiva a precios muy por debajo del mercado.
- Enterprise e integración: Microsoft (Azure OpenAI + Copilot) o Amazon (Bedrock) — cuando el ecosistema corporativo importa más que el modelo en sí.
- Multimodal avanzado: Google (Gemini) — el mejor en el procesamiento combinado de texto, imagen y video.
📝 Ejemplo: Si necesitas un chatbot interno para responder preguntas sobre la documentación de la empresa (escenario RAG), la elección más pragmática sería: Claude Sonnet (mejor relación costo-beneficio en razonamiento) vía Azure OpenAI o Bedrock (si ya usas AWS/Azure) con un MCP Server para acceder a tus fuentes de datos.
Cómo se Conecta Todo
Ahora que conoces cada pieza, mira cómo encajan en el ecosistema moderno:
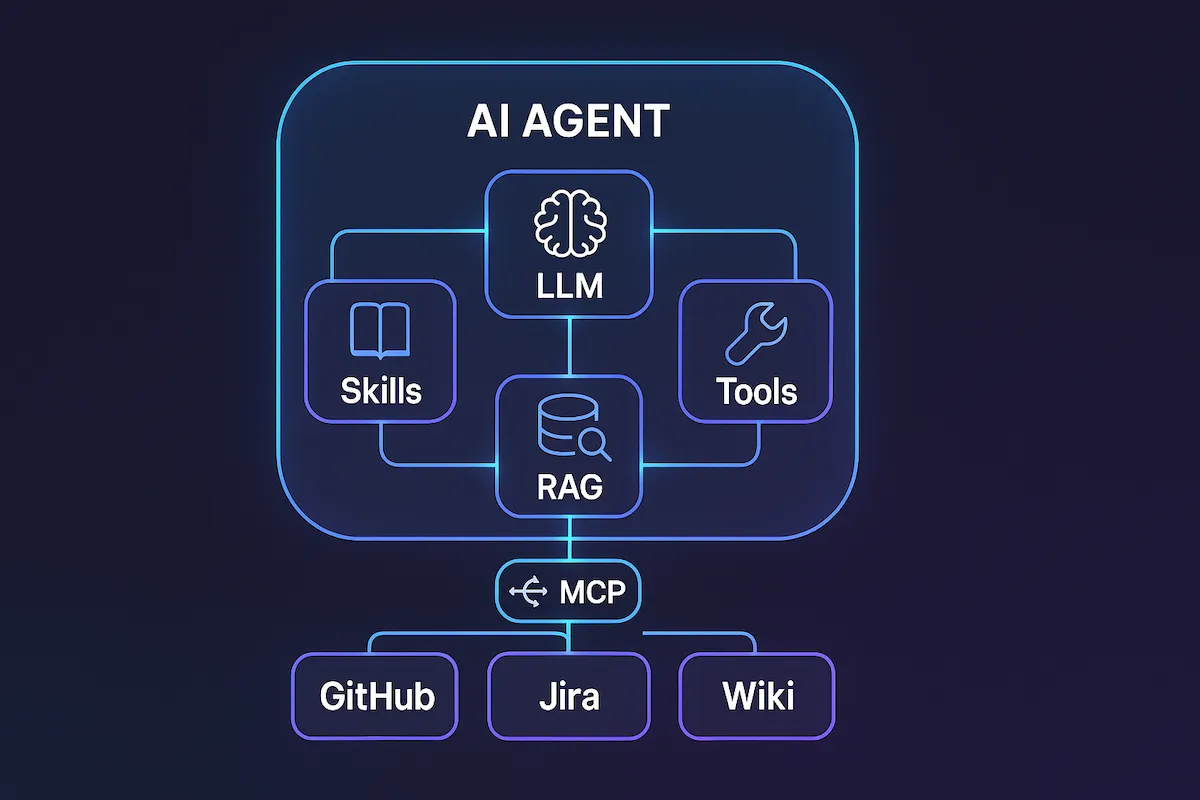
El LLM es el cerebro. Las Skills aportan conocimiento especializado. RAG proporciona datos actualizados. Las Tools permiten acciones reales. MCP lo conecta todo con un protocolo estandarizado. Y el Agente orquesta cada pieza para completar tareas complejas de forma autónoma.
Consejos y Buenas Prácticas
Si estás empezando a trabajar con IA en tu día a día profesional, aquí van algunas recomendaciones prácticas:
Empieza por lo que resuelve un problema real. No adoptes IA por hype. Identifica un dolor concreto de tu equipo — documentación desactualizada, respuestas repetitivas en soporte, code reviews lentos — y aplica IA en ese punto específico.
No confíes ciegamente en los outputs de los LLMs. Trata la salida del modelo como el borrador de un becario competente: normalmente útil, a veces brillante, pero siempre necesita la revisión de alguien que entienda del tema.
Entiende el costo antes de integrar. Las APIs de IA cobran por token. Una integración mal diseñada puede generar facturas altas rápidamente. Monitorea el consumo, define límites y usa modelos más pequeños cuando la tarea lo permita.
RAG antes que fine-tuning. Si el problema es que el LLM no conoce tus datos, empieza con RAG. El fine-tuning es caro, difícil de mantener y rara vez necesario para casos de uso corporativos.
Adopta MCP para las integraciones. Si vas a conectar un agente a herramientas internas, usa MCP. Crear integraciones propietarias es deuda técnica — el protocolo estandarizado facilita el mantenimiento y permite cambiar de modelo sin rehacer las integraciones.
Las skills son baratas y poderosas. Antes de invertir en soluciones complejas de personalización, intenta escribir instrucciones claras (skills) para el agente. Un buen prompt con contexto bien definido resuelve más que un fine-tuning mal hecho.
La autonomía de los agentes exige gobernanza. Antes de dar permisos de escritura a un agente (ejecutar comandos, modificar archivos, abrir PRs), define políticas de aprobación y límites claros. Human-in-the-loop no es burocracia — es seguridad.
Conclusión
La sopa de siglas de la IA puede parecer intimidante, pero cada concepto tiene un papel claro y bien definido. La IA es el campo amplio. Los Modelos son los cerebros entrenados. Los LLMs son los modelos de lenguaje que generan texto y código. RAG resuelve el problema de los datos que el LLM no conoce. Los Agentes añaden autonomía y capacidad de acción. Las Skills aportan conocimiento especializado. Y MCP lo conecta todo con un protocolo abierto y estandarizado.
El ecosistema de IA ya no es un experimento de laboratorio — es una realidad que ya está en las herramientas que los profesionales de TI usan a diario (Copilot, ChatGPT, Claude, Gemini). Entender los conceptos fundamentales no es opcional: es lo que separa a quien usa la herramienta de quien entiende la herramienta. Y quien la entiende, la usa mejor.
Mi recomendación: no intentes aprenderlo todo de una vez. Elige un concepto de este artículo que se aplique a tu trabajo ahora — quizá RAG para un chatbot interno, quizá MCP para estandarizar integraciones, quizá simplemente entender mejor cómo funciona por dentro el LLM que ya usas — y profundiza en él. El conocimiento práctico se construye pieza a pieza.
Si quieres profundizar en cómo la IA está impactando específicamente la carrera de los desarrolladores, te recomiendo leer el artículo de abajo. Y si tienes dudas o quieres discutir algún concepto, los comentarios están abiertos.
Lee También
- ¿La IA Reemplazará a los Desarrolladores? Opinión Honesta — Un análisis detallado del impacto real de la IA generativa en la carrera de los desarrolladores.
- GitHub Copilot: Agentes de IA, Modelos y Guía Completa — Todo sobre los agentes de IA y modelos de GitHub Copilot: cuáles son, cuándo usar cada uno y cómo funciona el consumo de tokens.
Referencias
- OpenAI — GPT-4o Documentation — Documentación oficial de los modelos de OpenAI, incluidas capacidades y límites.
- Anthropic — Claude Model Card — Especificaciones técnicas, ventanas de contexto y diferencias entre Opus, Sonnet y Haiku.
- Model Context Protocol — Specification — Especificación oficial de MCP, con guías de implementación para servers y clients.
- Google — Gemini API Documentation — Documentación de Gemini, incluidos los recursos multimodales y los límites de tokens.
- Meta — Llama Models — Página oficial de los modelos Llama, con enlaces de descarga y documentación de uso.
- Microsoft — Azure AI Services — Documentación del ecosistema de IA de Microsoft, incluidos Azure OpenAI y el Copilot Stack.
- Lewis, P. et al. — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020) — El paper original que introdujo el concepto de RAG.
Al comentar, aceptas nuestra Política de Privacidad, Términos de Uso, Política de Eliminación de Datos.