Introducción
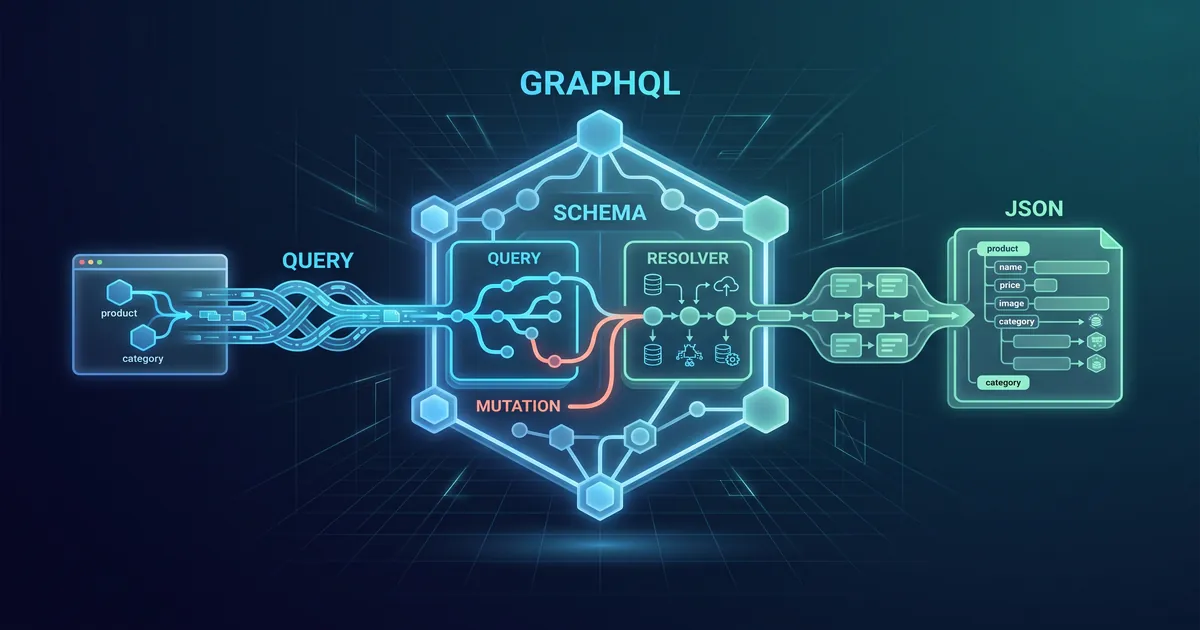
GraphQL es un lenguaje de consulta para APIs y un runtime que ejecuta esas consultas sobre un schema tipado. En lugar de recibir siempre una representación fija de un recurso, el cliente describe los campos que necesita; el servidor valida la operación, llama a los resolvers responsables y devuelve un JSON con esa forma. Yo consideraría GraphQL cuando distintos clientes necesitan combinaciones variadas de datos o cuando una pantalla depende de información relacionada que hoy exige varias llamadas, siempre que el equipo también esté preparado para controlar el costo de las consultas.
Esa flexibilidad no hace que GraphQL sea automáticamente más rápido, más pequeño o más simple que REST. Traslada parte del trabajo al schema y a los resolvers: el cliente elige los campos, pero el servidor sigue siendo responsable de la autorización, la validación, los límites de consulta, la paginación y el acceso eficiente a los datos. Una query mal controlada todavía puede hacer que el backend ejecute trabajo excesivo.
En esta guía explico schema, types, queries, mutations y resolvers, muestro una implementación ejecutable con GraphQL.NET en ASP.NET Core/.NET 10 y comparo la misma lectura con un endpoint REST. También separo lo que la demo realmente implementa de las medidas que una API de producción necesita agregar. Este es el segundo artículo de la serie APIs y Comunicación en .NET: la parte 1 presenta gRPC y sus criterios de uso; la próxima será una guía específica de SignalR.
ℹ️ Información: el sample probado usa GraphQL.NET 8.8.5, GraphQL.Server.Transports.AspNetCore 8.3.3 y .NET SDK 10.0.402. La query, la mutation, la validación y el endpoint REST se ejercitaron por HTTP en el proceso real de la API.
Requisitos previos
Para seguir el ejemplo, necesitas C# básico, familiaridad con HTTP y .NET SDK 10.0.400 o superior. El código completo está en el repositorio BlogSamples; clónalo e inicia la API con la URL explícita:
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
La API agregadora también inicia otros dominios del repositorio. El worker de outbox existente depende de PostgreSQL y registra fallos de conexión si el servicio no está disponible; eso no es una dependencia del tutorial de GraphQL. Los endpoints de este ejemplo usan el servicio de productos en memoria, y cualquier producto creado desaparece cuando el proceso termina.
Qué es GraphQL y cómo se ejecuta una operación
GraphQL no es sinónimo de JSON ni de HTTP. GraphQL define un lenguaje para expresar operaciones y una especificación para schemas, tipos, validación y ejecución. HTTP suele transportar la operación y la respuesta, pero el transporte es una capa separada. Una API GraphQL puede usar un endpoint HTTP como /graphql; la query se envía en el cuerpo de una petición POST o, en escenarios apropiados, en una petición GET.
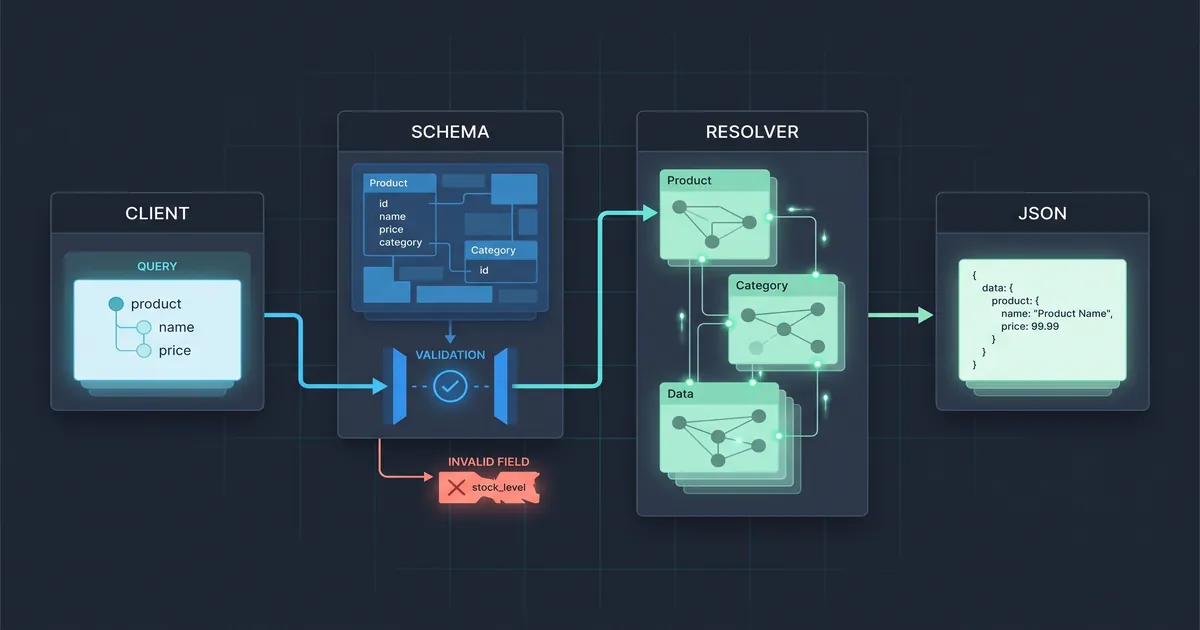
El schema (esquema) es el contrato que describe los tipos, campos, argumentos y operaciones que el servidor acepta. Una query recorre ese grafo de campos. Por ejemplo, product puede devolver un Product, y ese tipo puede ofrecer id, name, price y category. El contrato describe lo que se puede solicitar, no necesariamente cómo se almacenan los datos: pueden venir de una tabla, de una API externa, de una caché o de más de una fuente.
En una petición, el servidor primero interpreta la sintaxis de la operación. Después valida si los campos y argumentos existen en el schema y si los tipos son compatibles. Si la operación pasa, el ejecutor resuelve los campos solicitados y arma una respuesta JSON con la misma forma que la selección. Un fallo de validación impide la operación antes de llamar a los resolvers; un fallo durante la ejecución puede devolver data parcial o nulo junto con errors.
⚠️ Atención: el lenguaje GraphQL define la operación, no una promesa de transporte universal. El ejemplo usa HTTP POST con JSON; WebSockets y subscriptions son otro alcance y no forman parte de esta implementación.
Schema, types, queries, mutations e inputs
Un type es un tipo del schema. GraphQL define scalars como String, Int, Float, Boolean e ID; el schema también puede declarar enums, tipos de objeto e input objects. Product y Category son tipos de salida: describen los datos que el servidor puede devolver. Un input object agrupa valores recibidos, generalmente para una mutation con varios parámetros.
El schema tiene un root type de lectura, normalmente llamado Query, y puede tener un root Mutation para operaciones de escritura. Subscription se usa para actualizaciones continuas cuando la implementación elige un transporte compatible. Esos nombres son convenciones del contrato, no nombres obligatorios de tablas o clases. Un campo puede recibir argumentos y devolver un objeto, una lista, un scalar o un valor nullable.
El ejemplo usa CreateProductInput para agrupar name, description, price, stock y categoryId. Eso deja legible la firma de la mutation y facilita evolucionar los datos de entrada. En el resolver, los valores se convierten al CriarProdutoRequest que la API ya usa. La entrada pasa por una validación explícita de nombre, precio, stock y categoría antes de llamar al servicio.
Un enum limita un campo a valores con nombre, como DRAFT y PUBLISHED, en lugar de aceptar cualquier string. Los tipos no nulos (Product!) y las listas ([Product!]!) también expresan la nulabilidad en el contrato; usa esas garantías solo cuando la aplicación pueda cumplirlas.
Una mutation no sustituye reglas de dominio ni una transacción. El schema determina la forma de entrada y salida; el resolver llama a la aplicación, que debe validar las invariantes, autorizar al usuario y controlar la persistencia y los efectos secundarios. En el sample, el almacenamiento es deliberadamente en memoria y no hay autenticación. Eso basta para demostrar el flujo, no para representar una API de producción.
El papel de los resolvers y el problema N+1
Un resolver es la función que obtiene el valor de un campo. Puede leer una propiedad ya cargada, consultar un servicio o componer resultados de fuentes diferentes. Los argumentos de la query llegan al resolver por el contexto de ejecución; las dependencias de la aplicación pueden obtenerse del contenedor de inyección de dependencias. El schema no exige que cada campo haga su propia consulta: los campos hermanos pueden compartir datos, y una capa de aplicación puede devolver un objeto ya preparado.
En el sample, el resolver del root product(id:) llama a IProdutoService.ObterProdutoPorIdAsync. El campo category usa el CategoriaId del DTO y pide la categoría al mismo servicio. En una query para un solo producto, eso es fácil de seguir. Si el schema pasara a listar decenas de productos y cada elemento buscara su categoría individualmente, el patrón podría generar una consulta para la lista y una más para cada categoría: el problema N+1.
El DataLoader agrupa las claves solicitadas durante una ejecución y permite buscar varios valores en lote; también puede reutilizar el resultado para claves repetidas dentro de ese contexto. Con 50 pedidos que cargan usuarios, por ejemplo, la aplicación puede hacer una búsqueda de los pedidos y una búsqueda en lote de los usuarios, en lugar de 51 accesos separados. La ganancia depende de que la fuente ofrezca una operación en lote y de que el loader esté configurado en el ámbito correcto; no es una optimización automática de cualquier resolver.
Por eso, mantén los resolvers delgados: delega la operación a servicios que concentren la autorización y las reglas de dominio, limita las listas y propaga la cancelación y los errores. La demo no implementa DataLoader porque consulta solo un producto y una categoría, sin una lista que exponga N+1.
GraphQL.NET en ASP.NET Core y .NET 10
GraphQL.NET proporciona el ejecutor, los tipos y los recursos de integración con inyección de dependencias. El transporte de ASP.NET Core agrega middleware HTTP para recibir operaciones en el endpoint. En el sample, GraphQL y sus paquetes de DI y serialización están fijados en 8.8.5, mientras que GraphQL.Server.Transports.AspNetCore está en 8.3.3; los paquetes verificados declaran licencia MIT y targets compatibles con frameworks superiores.
La documentación actual de integración de GraphQL.NET presenta un quickstart cuyo TargetFramework es net10.0. La página de NuGet del transporte 8.3.3 todavía describe compatibilidad del middleware hasta ASP.NET Core 9. Como esas informaciones no coinciden, no trato la declaración de targets de NuGet como prueba aislada del runtime: restauré y compilé los paquetes en el SDK 10.0.402 y ejecuté una query, una mutation y un error de validación en el endpoint real del sample en .NET 10.
El registro de servicios conecta el schema con la implementación JSON. Los graph types que el schema descubre también necesitan estar disponibles en el DI:
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
Después de construir la aplicación, el middleware recibe operaciones en /graphql:
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
El sample registra ProdutoSchema, cuyo root Query contiene product(id:) y cuyo root Mutation contiene createProduct(input:). No hay GraphiQL, subscriptions, una base de datos nueva ni otro motor GraphQL en este ejemplo.
Ejemplo Práctico
Voy a consultar el producto con ID 1, que en el seed de la API es el Smartphone Galaxy S25. La query pide solo identificador, nombre, precio y nombre de la categoría; las variables quedan separadas del texto de la operación, lo que facilita reutilizar la query sin interpolar valores en el string.
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
Respuesta observada en el sample (los datos del seed están en portugués):
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
Ahora hago la lectura REST del mismo ID:
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
| |
El endpoint REST del sample devuelve la representación que su contrato definió; la query GraphQL del ejemplo pidió una proyección específica en el propio documento. Eso ilustra dos interfaces concretas, no una limitación intrínseca de REST. Una API REST también puede tener endpoints especializados, parámetros de proyección o representaciones diferentes. Ambos JSON provienen de la misma fuente en memoria, pero cada contrato expone un formato distinto.
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
Para crear un producto, envío un CreateProductInput. El primer producto creado en una ejecución limpia recibió el ID 53; la mutation devuelve ese valor y los campos seleccionados:
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
El resolver rechaza un precio igual a cero antes de llamar a IProdutoService. El transporte devuelve HTTP 200, pero la respuesta incluye errors y createProduct: null; por eso, un cliente GraphQL debe examinar el cuerpo de la respuesta, no solo el status HTTP.
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
Una query que intenta seleccionar un campo inexistente se rechaza antes de la ejecución. En el servidor probado, ese fallo de validación devolvió HTTP 400 con el código FIELDS_ON_CORRECT_TYPE.
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
| |
📂 Código Fuente: el ejemplo completo está disponible en el repositorio de ejemplos del blog:
BlogSamples/GraphQL/
Seguridad y límites operativos
GraphQL no sustituye la autenticación ni la autorización. Conocer el ID de un objeto no prueba que el usuario pueda leerlo o modificarlo. El servidor debe verificar la autorización a nivel de recurso y, cuando sea necesario, de cada campo; las mutations necesitan validar al usuario y la regla de dominio antes de producir efectos. Una verificación solo en el endpoint puede ser insuficiente cuando el mismo schema expone datos con niveles de acceso diferentes.
La flexibilidad también crea un presupuesto de ejecución. Una API que acepta listas debe imponer paginación con límite máximo, restringir profundidad y complejidad cuando el grafo permite consultas costosas, controlar el batching y aplicar timeouts y rate limits por identidad o cliente. El tamaño del cuerpo HTTP también necesita un límite. Contar requests de forma aislada no mide el trabajo: una sola operación puede seleccionar muchos campos o repetir llamadas a objetos diferentes.
La introspection permite que los clientes consulten el propio schema. Es útil para herramientas, pero evalúa su exposición; restringirla no sustituye la autorización ni los límites de costo. No expongas GraphiQL sin necesidad y evita stack traces y detalles internos en errores de producción.
El transporte GraphQL.NET 8.3.3 habilita la protección CSRF por defecto y no habilita el procesamiento de formularios POST por defecto. Aun así, una API con autenticación por cookie necesita revisar los métodos aceptados, CORS, headers y mecanismos de CSRF en la configuración real. Para mutations, usa POST; no trates la validación de tipos como autorización y no confíes en datos del cliente sin validar las invariantes en el dominio.
En la demo, la validación de nombre, precio, stock y categoría está implementada, pero la API no tiene login, política de autorización, rate limit, límite de complejidad ni persistencia. La introspection permanece disponible y no existe interfaz GraphiQL. Son límites deliberados del ejemplo didáctico; no los interpretes como configuración recomendada para una API pública.
⚠️ Atención: el schema describe los campos disponibles, no quién puede acceder a ellos. Cada resolver o caso de uso necesita aplicar las reglas de acceso al dato y a la operación.
GraphQL, REST y gRPC: cómo elegir
Yo empezaría por los consumidores, el contrato y el tráfico, no por la preferencia del equipo. GraphQL atiende combinaciones variables de datos; REST organiza recursos y semántica HTTP; gRPC define métodos y mensajes tipados para servicios controlados y streaming.
| Criterio | REST | GraphQL | gRPC |
|---|---|---|---|
| Contrato | Recursos, URLs y semántica HTTP | Schema tipado y campos seleccionables | Servicios y mensajes en un contrato Protobuf |
| Selección de datos | Representación definida por el endpoint; puede tener proyecciones | Selección escrita en cada query | Estructura del mensaje definida por el método |
| Caché | Se integra directamente con la semántica de caché HTTP para GET | Depende del transporte, la operación y la estrategia de caché adoptada | Normalmente exige una estrategia de la aplicación o un intermediario compatible |
| Streaming | HTTP permite streaming, según el endpoint y el formato | Las subscriptions dependen de un transporte y un protocolo configurados | Streaming unario, de servidor, de cliente o bidireccional forma parte del modelo RPC |
| Cliente común | Navegadores, servicios y herramientas HTTP | Clientes que entienden el schema y envían operaciones GraphQL | Servicios con contrato y cliente generado; el navegador puede necesitar gRPC-Web |
| Costo operativo | Modelar recursos y evolucionar representaciones | Operar schema, resolvers, autorización y límites de query | Generar/versionar contratos, configurar HTTP/2 y operar streams |
En el ejemplo anterior, GET /api/products/1 devuelve descripción, stock y categoría aplanada, mientras que la query GraphQL selecciona id, name, price y category { name }. Eso muestra el contrato que implementé: no prueba que REST siempre devuelva campos de más. Una ruta REST podría ofrecer una proyección o una representación más pequeña; compara contratos concretos en lugar de patrones caricaturizados.
Para un cliente web con lecturas compuestas y requisitos variables, GraphQL puede concentrar la coordinación y reducir llamadas específicas, siempre que los límites y los resolvers estén bien diseñados. Para recursos que encajan en métodos HTTP y caché convencional, REST puede ser más simple. Para servicios internos que necesitan contratos generados o streams continuos, gRPC puede encajar mejor. Es posible usar más de un estilo en partes diferentes de un producto; ninguno gana en todos los escenarios.
Consejos y Buenas Prácticas
Modela el dominio antes que la base de datos. Los tipos y campos deben representar el contrato útil para los clientes, no reflejar tablas o entidades internas. Eso permite que la API evolucione sin exponer la estructura de persistencia.
Mantén los resolvers pequeños. Úsalos para reenviar argumentos a servicios y armar resultados, no para concentrar autorización, reglas de negocio y consultas ad hoc. La lógica importante necesita ser reutilizable y testeable fuera de GraphQL.
Pon límites en toda lista. La paginación con tamaño máximo evita que una selección válida pida un volumen ilimitado de objetos. Combina ese límite con análisis de profundidad o costo cuando el schema tenga relaciones amplias.
Trata N+1 como un riesgo de acceso a datos. Mide cuántas llamadas dispara cada query y usa DataLoader cuando varios resolvers pidan claves que puedan agruparse. El batching necesita respetar el tenant, la autorización y el ámbito de la petición.
Valida y autoriza las mutations en el dominio. Los tipos GraphQL ayudan a rechazar formatos inválidos, pero no sustituyen reglas de negocio ni permisos por registro. Devuelve errores útiles sin exponer stack traces, SQL o datos internos.
Evoluciona el schema de forma compatible. Prefiere agregar campos y deprecar los antiguos con un plazo claro antes de eliminarlos. Sigue qué clientes todavía usan cada campo y trata los cambios incompatibles como una migración explícita.
Conclusión
GraphQL ofrece al cliente un lenguaje para seleccionar datos dentro de un contrato tipado. Ese modelo es especialmente útil cuando los consumidores necesitan combinaciones distintas de información, pero exige atención al costo de cada operación, a los resolvers, a la autorización y a la evolución del schema. La implementación mostrada usa GraphQL.NET 8.8.5 y el transporte ASP.NET Core 8.3.3 en .NET 10, sobre los mismos productos en memoria que alimentan un endpoint REST.
No elegiría GraphQL solo porque una query puede pedir pocos campos. REST también admite proyecciones y representaciones especializadas, y gRPC resuelve otros problemas de contrato y streaming. La decisión debe partir de los clientes, los flujos de lectura y escritura, la caché, el transporte y la capacidad de operar la solución. En la próxima parte de la serie, trataré SignalR como una opción para comunicación en tiempo real en .NET, sin confundir ese problema con consultas de datos.
Resumen Objetivo
- GraphQL es un lenguaje de consulta y un runtime que ejecuta operaciones sobre un schema tipado; el cliente selecciona campos y el servidor valida y resuelve cada operación.
- Query y Mutation son roots del schema GraphQL normalmente usados para lectura y escritura; las mutations todavía necesitan validación de dominio, autorización y control de efectos secundarios.
- GraphQL.NET 8.8.5 y GraphQL.Server.Transports.AspNetCore 8.3.3 ejecutaron query, mutation y validación HTTP en una API ASP.NET Core/.NET 10 del sample BlogSamples.
- DataLoader puede agrupar búsquedas hechas por resolvers y reducir el patrón N+1 cuando la fuente de datos ofrece una operación en lote; no elimina la necesidad de límites ni de autorización.
- REST puede ofrecer proyecciones y representaciones especializadas; la diferencia entre los JSON de este artículo describe solo los contratos concretos probados.
- GraphQL, REST y gRPC tienen modelos y costos operativos diferentes; la elección depende de los clientes, el contrato, el transporte y las necesidades de streaming y caché.
Lee También
- gRPC desmitificado: qué es y cuándo usarlo en .NET 10
- Diseño de API REST: Verbos HTTP y Parameter Binding
- Tiempo real en Angular y .NET: WebSockets, SSE y SignalR
Referencias
- GraphQL Learn — introducción oficial a schemas, queries, mutations y prácticas de operación.
- GraphQL Specification — September 2025 — semántica normativa del lenguaje y del sistema de tipos.
- GraphQL.NET ASP.NET Core Integration — configuración actual del transporte y ejemplo de integración con .NET 10.
- GraphQL.NET DataLoader — batching y caché por petición para relaciones resueltas por campo.
- GraphQL.NET Server — middleware de ASP.NET Core, transporte HTTP y configuración de seguridad.
- OWASP GraphQL Cheat Sheet — recomendaciones de validación, autorización, introspection y límites de consultas.
- GraphQL over HTTP — especificación en desarrollo para transportar operaciones GraphQL sobre HTTP.
Al comentar, aceptas nuestra Política de Privacidad, Términos de Uso, Política de Eliminación de Datos.