
Introducción
Todo desarrollador .NET que trabaja con aplicaciones medianas o grandes ya se ha topado con al menos uno de estos escenarios: una rutina nocturna que necesita grabar 50 mil pedidos en la base de datos, una consulta de informe que trae 300 mil registros de una sola vez y congela la aplicación, o una API que tarda 8 segundos en responder porque EF Core está ejecutando 10 mil INSERT individuales en secuencia.
SQL Server y Oracle son bases de datos robustas y maduras, pero ninguna de las dos fue diseñada para recibir miles de escrituras en ráfaga, ni para devolver cientos de miles de filas de una sola vez sin costo. En la mayoría de los casos, el problema no es la base de datos — es la forma en que la aplicación C# interactúa con ella.
En este artículo exploro las dos caras del cuello de botella: escritura masiva y lectura de grandes volúmenes. Para cada una, verás la causa raíz, las particularidades de SQL Server y Oracle con EF Core 8.0+, y la solución práctica — mensajería para escrituras y paginación eficiente para lecturas. Todo el código está listo para producción y es compatible con .NET 8/9.
Requisitos previos: Conocimientos básicos de C# y EF Core. Recomiendo leer el artículo sobre programación asíncrona con C# antes de continuar.
📦 Código fuente: La implementación completa de este artículo está en el repositorio blog-zocateli-sample en GitHub. Clónalo, explóralo y adáptalo a tu contexto.
El Cuello de Botella de la Escritura: Por Qué Grabar Miles de Registros Duele
El Costo Real de Cada INSERT
Cuando guardas una lista de entidades con EF Core de la forma más común, ocurre algo así:
| |
Cada SaveChangesAsync() dentro del bucle representa:
- Una transacción abierta → confirmada → cerrada en la base de datos
- Un roundtrip de red (latencia de 1–5ms por llamada)
- El log de la base de datos siendo escrito en cada operación
- Locks de fila asignados y liberados 50 mil veces
Para 50.000 pedidos con 2ms de latencia por roundtrip, son 100 segundos de procesamiento de I/O puro. Y ese es el mejor escenario, sin contención.
Particularidades: SQL Server vs Oracle
Aunque la solución es parecida en ambas bases de datos, hay diferencias importantes:
| Aspecto | SQL Server | Oracle |
|---|---|---|
| Bulk insert nativo | BULK INSERT / SqlBulkCopy | ODP.NET BulkCopy / INSERT ALL |
| Tamaño máximo de lote por defecto | 1.000 filas por INSERT | Depende de ArrayBindCount |
| Sequences / Identity | IDENTITY o SEQUENCE | Solo SEQUENCE (obligatorio) |
| Rollback de bulk | Puede ser mínimamente registrado | Siempre registrado (redo log) |
| Provider EF Core | Microsoft.EntityFrameworkCore.SqlServer | Oracle.EntityFrameworkCore |
En Oracle, un detalle crítico es que el provider oficial (Oracle.EntityFrameworkCore 8.x) exige configurar la generación de claves vía SEQUENCE + TRIGGER (o GENERATED ALWAYS AS IDENTITY en Oracle 12c+). Ignorar esto en escrituras masivas generará N llamadas extra a la base de datos solo para obtener los IDs.
| |
La Solución Inmediata: SaveChanges por Lotes con EF Core 8
Antes de introducir colas, la primera optimización es sacar SaveChangesAsync() del bucle y usar chunks para no sobrecargar el contexto:
| |
💡 Consejo: El método Chunk() fue introducido en .NET 6. Combinado con ChangeTracker.Clear(), evita que el contexto de EF Core crezca indefinidamente al rastrear decenas de miles de entidades.
ExecuteInsertAsync y BulkInsert en EF Core 8
EF Core 7 trajo ExecuteUpdateAsync y ExecuteDeleteAsync. EF Core 8 mejoró el soporte para operaciones en lote. Para escenarios de altísimo rendimiento, usa la biblioteca EFCore.BulkExtensions:
| |
Con BulkInsert, 50.000 registros que tardaban 100 segundos con SaveChanges individuales se graban en 2–4 segundos en SQL Server, y en 3–6 segundos en Oracle.
Mensajería: La Solución Arquitectónica para Escrituras Masivas
Optimizar el INSERT en sí trata el síntoma, pero no la causa raíz. El verdadero problema es que la aplicación intenta procesar un volumen enorme de forma síncrona, bloqueando el hilo y la request mientras graba. La solución arquitectónica correcta es desacoplar la recepción de la grabación usando una cola de mensajes.
Cómo la Mensajería Resuelve el Problema
En lugar de grabar directamente en la base de datos al recibir los datos, la aplicación:
- Publica los registros en una cola (RabbitMQ, Azure Service Bus, etc.) — operación rápida (~1ms por mensaje)
- Responde inmediatamente al cliente con
202 Accepted - Un Consumer separado lee la cola en lotes y graba en la base de datos con bulk insert
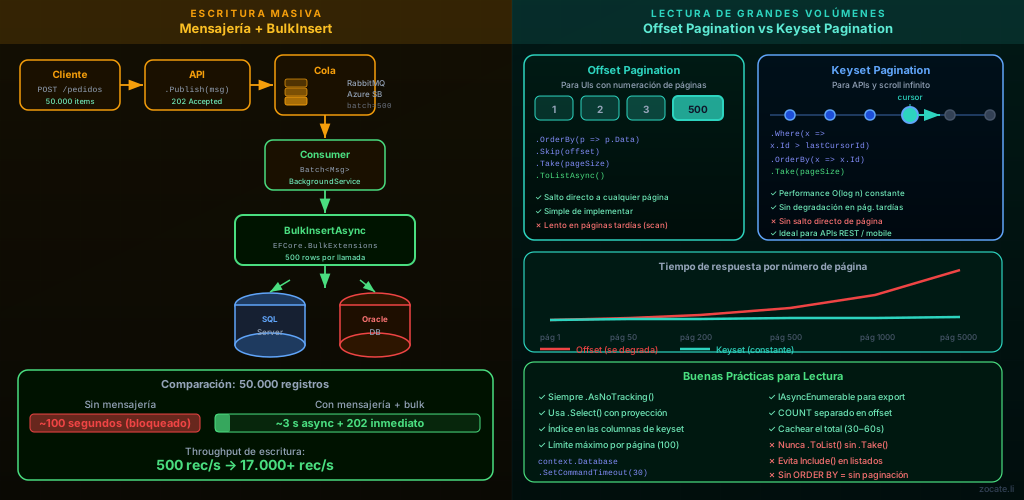
Esta separación trae beneficios más allá del rendimiento:
- Resiliencia: si la base de datos cae temporalmente, los mensajes permanecen en la cola. No hay pérdida de datos.
- Control de flujo: el consumer puede procesar a la velocidad que la base de datos soporta
- Backpressure natural: la cola absorbe picos de carga
- Observabilidad: puedes monitorear el tamaño de la cola y saber exactamente el backlog pendiente
Implementación con RabbitMQ.Client
La biblioteca oficial RabbitMQ.Client es 100% open source (Apache 2.0) y ofrece acceso directo al protocolo AMQP. Combinada con el BackgroundService de .NET, implemento un consumer que acumula mensajes en un lote y graba todo de una vez con BulkInsert.
| |
Registro en Program.cs
| |
⚠️ Atención: En Oracle, el BulkInsert de EFCore.BulkExtensions requiere el Oracle Data Provider for .NET (ODP.NET). Asegúrate de registrar el provider correcto y de que las sequences estén configuradas correctamente en el modelo, o el bulk insert fallará con un error de constraint de clave primaria.
RabbitMQ vs Azure Service Bus: ¿Cuál Elegir?
Ambas opciones resuelven el mismo problema — desacoplar la producción y el consumo de mensajes — pero con modelos operativos y económicos muy distintos. La elección depende de tu contexto: infraestructura propia vs nube gestionada, costo variable vs fijo, y el grado de control que deseas.
| Criterio | RabbitMQ | Azure Service Bus |
|---|---|---|
| Tipo | Open source (MPL 2.0), self-hosted | PaaS gestionado por Microsoft |
| Protocolo | AMQP 0-9-1 (nativo), AMQP 1.0, MQTT, STOMP | AMQP 1.0 |
| Hospedaje | Contenedor propio, VM, Kubernetes | Azure (sin infra que gestionar) |
| Costo | Infraestructura + operación (tu equipo) | Pago por uso (~$0,10/millón de ops) |
| Colas | Queues, Exchanges, Bindings | Queues y Topics/Subscriptions |
| Tamaño máximo de mensaje | 128 MB (por defecto) | 256 KB (Standard) / 100 MB (Premium) |
| Retención de mensajes | Hasta llenar el disco / TTL configurable | 14 días (máximo) |
| Dead-letter queue | ✅ Configurable | ✅ Nativo |
| Sesiones (orden garantizado) | ✅ Vía x-single-active-consumer | ✅ Service Bus Sessions |
| Retry automático | Manual (Dead-letter + requeue) | Nativo (MaxDeliveryCount) |
| Escalabilidad horizontal | Manual (cluster Erlang) | Automática |
| Biblioteca .NET | RabbitMQ.Client (Apache 2.0) | Azure.Messaging.ServiceBus (MIT) |
| Ideal para | On-premises, multi-cloud, costo controlado | Ecosistema Azure, equipo pequeño, SLA garantizado |
Implementación Equivalente con Azure Service Bus
Para migrar de RabbitMQ a Azure Service Bus en un entorno Azure, el patrón producer/consumer es similar, usando Azure.Messaging.ServiceBus:
| |
💡 Consejo: En producción en Azure, prefiere la autenticación vía Managed Identity en lugar de una connection string, usando new ServiceBusClient("meu-namespace.servicebus.windows.net", new DefaultAzureCredential()). Esto elimina secretos de la configuración.
El Cuello de Botella de la Lectura: Por Qué Traer Todo de Una Vez Es Peligroso
El Problema de la Consulta Sin Límite
| |
Esta consulta aparentemente inocente puede:
- Consumir gigabytes de RAM en el servidor de la aplicación
- Bloquear la base de datos con un table scan prolongado
- Generar timeouts en entornos de alta concurrencia
- Saturar la red entre la aplicación y la base de datos con tráfico innecesario
- Asfixiar el GC de .NET con objetos grandes que deben ir al LOH (Large Object Heap)
En Oracle, un aspecto adicional es el uso de ROWNUM (Oracle 11g) vs FETCH FIRST … ROWS ONLY (Oracle 12c+), lo que afecta cómo se expresa la paginación en SQL. El provider Oracle.EntityFrameworkCore lo abstrae, pero es importante entender lo que se está generando.
Tipos de Paginación: Offset vs Keyset (Cursor)
📖 Artículo dedicado: Para una guía completa de todas las estrategias de paginación (Offset, Keyset, Server-Side Cursor, Time-based y Opaque Token) con SQL Server, Oracle y PostgreSQL — incluido código EF Core 8+ para cada combinación —, consulta: Paginación en APIs REST con C# y EF Core: Guía Práctica. Esta sección presenta los conceptos esenciales; el artículo enlazado profundiza en cuándo y por qué usar cada enfoque.
Existen dos estrategias principales de paginación, y cada una tiene casos de uso distintos:
| Característica | Offset Pagination | Keyset (Cursor) Pagination |
|---|---|---|
| SQL generado | OFFSET N ROWS FETCH NEXT M | WHERE id > :lastId |
| Rendimiento en las primeras páginas | ✅ Rápido | ✅ Rápido |
| Rendimiento en páginas tardías | ❌ Lento (el scan crece) | ✅ Constante |
| Soporte a salto de página | ✅ Directo | ❌ Solo secuencial |
| Registros nuevos entre páginas | ❌ Puede duplicar/omitir | ✅ Consistente |
| Caso de uso ideal | UI con números de página | Scroll infinito / APIs |
Offset Pagination: Simple y Adecuada para UIs
La paginación por offset es la más conocida, y EF Core la genera correctamente para SQL Server y Oracle:
| |
💡 Consejo: Usa siempre .Select() con proyección (DTO o record); nunca devuelvas la entidad completa en consultas de listado. Esto reduce el volumen de datos transferidos y evita cargar navegaciones innecesarias.
SQL Generado: SQL Server vs Oracle
EF Core 8 genera SQL correcto y optimizado para ambas bases de datos:
| |
⚠️ Atención: Para Oracle 11g (sin FETCH FIRST), el provider genera una consulta con ROWNUM anidado, que puede tener costo adicional en tablas muy grandes. Considera migrar a Oracle 12c+ o usar vistas materializadas para informes pesados.
Keyset Pagination: Alto Rendimiento para Scroll Infinito y APIs
Cuando el usuario navega a la página 500 de un resultado con 10 mil ítems, la base de datos necesita hacer un scan de 10.000 filas solo para saltar las primeras 9.980. Con keyset pagination, usas el valor de la última fila obtenida como punto de partida de la siguiente consulta:
| |
Este patrón mantiene un rendimiento constante independientemente del número de página, porque el SQL generado usa un WHERE indexado simple en lugar de OFFSET.
| |
💡 Consejo: Crea un índice compuesto en las columnas del keyset para garantizar que la consulta use un index seek en lugar de un table scan:
| |
Uniendo Todo: La Arquitectura Completa
Con ambas soluciones combinadas, la arquitectura de la aplicación queda así:
- Escritura: la API recibe → publica en la cola → responde
202 Accepted→ el Consumer procesa en lotes con BulkInsert - Lectura: la API recibe una request paginada → ejecuta la consulta con Skip/Take (offset) o WHERE (keyset) → devuelve solo los datos necesarios
| |
Consejos y Buenas Prácticas
- Índices adecuados: Toda columna usada en
OrderBy,Whereo cursor de keyset debe tener un índice. En Oracle, usa índices basados en funciones para columnas con transformaciones (ej.:UPPER(nome)). - AsNoTracking siempre en lecturas: Desactiva el Change Tracker en consultas de lectura, reduciendo el uso de memoria y CPU hasta en un 30%.
- Evita
Count()en tablas grandes: Para keyset pagination, no necesitas el total de registros. Para offset, considera cachear el total durante algunos segundos. - Define timeouts explícitos: Configura
context.Database.SetCommandTimeout(30)o usaWithTimeoutpor consulta para evitar que consultas largas bloqueen la aplicación indefinidamente. - Monitorea el tamaño de la cola: Configura alertas para cuando la cola supere N mensajes — es la señal de que el consumer no está dando abasto con el volumen.
- Usa
IAsyncEnumerablepara streaming: Para exportaciones CSV o procesamiento de grandes volúmenes que no necesitan paginación, usaAsAsyncEnumerable()para procesar fila por fila sin cargar todo en la memoria:
| |
- Transacciones explícitas para consistencia: Al usar BulkInsert con varias tablas (ej.: grabar
PedidoeItensPedidojuntos), envuelve la operación en una transacción explícita para garantizar la atomicidad.
Conclusión
Los cuellos de botella en bases de datos con EF Core rara vez son culpa de la base de datos en sí. En la inmensa mayoría de los casos, el problema está en cómo la aplicación interactúa con ella: insertar un registro a la vez en lugar de por lotes, y traer todo el resultado en lugar de paginar.
La combinación de mensajería (RabbitMQ o Azure Service Bus) para desacoplar escrituras masivas y paginación eficiente (offset para UIs, keyset para APIs y scroll infinito) resuelve ambos cuellos de botella de forma elegante, escalable y resiliente. Con EF Core 8.0+ y las técnicas presentadas aquí, puedes soportar volúmenes mucho mayores sin cambiar la estructura de la base de datos, solo ajustando la forma en que la aplicación se comunica con ella.
El siguiente paso natural es la observabilidad: instrumentar consultas lentas con Application Performance Monitoring (APM), crear alertas para consultas que superen N segundos y mapear índices faltantes vía Query Store (SQL Server) o AWR (Oracle).
Lee También
- EF Core 8 Fluent API: Mapeo, ORM y Desacoplamiento
- EF Core Migrations: Multiproyecto, Secrets y Scaffolding
- Full-Text Search en API REST: C#, SQL Server y PostgreSQL
- Arquitectura de Software: GoF, Patrones y Microservicios
- Diseño de API REST: Verbos HTTP y Parameter Binding
- Paginación en APIs REST con C# y EF Core: Guía Práctica
- Programación Asíncrona en C#: async/await y Threads
- Paralelismo en C#: Parallel, PLINQ y Tasks en la Práctica
- Worker y Background Service en .NET: Alto Volumen
Referencias
- EF Core — Bulk Operations (Microsoft Docs) — Estrategias oficiales de actualización eficiente con EF Core
- EFCore.BulkExtensions — GitHub — Biblioteca open source para bulk insert/update/delete en EF Core
- RabbitMQ.Client — NuGet / GitHub — Biblioteca .NET oficial para RabbitMQ (Apache 2.0)
- Azure.Messaging.ServiceBus — Documentación — Guía oficial de Azure Service Bus con .NET
- RabbitMQ vs Azure Service Bus — Comparación — Visión general de Azure Service Bus y cuándo usarlo
- Oracle EF Core Provider — GitHub — Ejemplos oficiales del provider Oracle para EF Core
- Usar el almacén de consultas (SQL Server) — Monitoreo de consultas lentas en SQL Server vía Query Store
- Repositorio blog-zocateli-sample — Messaging — Código fuente completo de los ejemplos de este artículo
Al comentar, aceptas nuestra Política de Privacidad, Términos de Uso, Política de Eliminación de Datos.