
Introducción
Si trabajas con .NET y EF Core en aplicaciones corporativas, ya te has encontrado con escenarios en los que necesitas grabar, actualizar o eliminar miles de registros de una sola vez. EF Core estándar ejecuta una operación SQL por cada entidad en el ChangeTracker: para 10.000 registros, eso son 10.000 roundtrips a la base de datos. En aplicaciones medianas y grandes, eso es inaceptable.
La biblioteca EFCore.BulkExtensions resuelve este problema de forma elegante, usando operaciones nativas de cada base de datos (como MERGE en SQL Server o INSERT ... ON CONFLICT en PostgreSQL) para procesar miles de registros en una única operación.
En este artículo, vas a conocer:
- Quién mantiene el proyecto y su relación con el ecosistema .NET
- El error clásico de tracking que el 90% de los desarrolladores comete (y atribuye a EF Core)
- Por qué EF Core se comporta así — y por qué es correcto
- Los 8 métodos de la biblioteca con ejemplos reales
- Integración con Azure Service Bus para procesamiento de alto volumen
Requisitos previos: Familiaridad con C# y EF Core. Se recomienda haber leído los artículos sobre Fluent API e mapeamento com EF Core y Cuello de Botella en Bases de Datos: Mensajería y Paginación antes de continuar.
📦 Código fuente: La implementación completa de este artículo está en el repositorio blog-zocateli-sample en GitHub. Clónalo, explóralo y adáptalo a tu contexto.
El Proyecto EFCore.BulkExtensions
Historia y Mantenimiento
EFCore.BulkExtensions es mantenido por Boris Djurdjevic (@borisdj), un ingeniero de software sénior de Serbia especializado en acceso a datos y rendimiento de bases de datos. El proyecto se creó en 2017 y rápidamente se convirtió en la biblioteca de operaciones bulk más popular del ecosistema .NET.
Cifras del proyecto (marzo de 2026):
| Métrica | Valor |
|---|---|
| ⭐ Stars en GitHub | 3.700+ |
| 📦 Descargas en NuGet | 30 millones+ |
| 🧑💻 Contribuidores | 70+ |
| 📋 Issues resueltos | 900+ |
| 🔄 Releases | 100+ |
| 📄 Licencia | MIT |
Relación con el Equipo de EF Core y la .NET Foundation
Es importante aclararlo: Boris Djurdjevic no es miembro del equipo de Entity Framework Core de Microsoft, ni EFCore.BulkExtensions es un proyecto oficial de la .NET Foundation. Se trata de un proyecto independiente de la comunidad open-source, con licencia MIT.
Aun así, el proyecto mantiene una compatibilidad rigurosa con cada versión de EF Core (3.x, 5.x, 6.x, 7.x, 8.x) y es ampliamente reconocido por la propia Microsoft en discusiones sobre rendimiento. Varios contribuidores del repositorio tienen experiencia profesional con SQL Server, PostgreSQL y Oracle, lo que explica la calidad de su soporte multi-provider.
Proveedores de Base de Datos Soportados
| Provider | Estrategia Bulk |
|---|---|
| SQL Server | SqlBulkCopy + MERGE (mejor rendimiento) |
| PostgreSQL | COPY + INSERT ... ON CONFLICT |
| MySQL | LOAD DATA + INSERT ... ON DUPLICATE KEY |
| SQLite | INSERT OR REPLACE |
| Oracle | Mediante un provider adaptado |
La biblioteca detecta automáticamente el provider configurado en el DbContext y usa la estrategia nativa más eficiente.
El Error Clásico: Delete → ReInsert y el ChangeTracker

El Escenario
Un escenario extremadamente común en aplicaciones corporativas: necesitas sincronizar datos de una fuente externa (CSV, API, otro sistema). El enfoque “intuitivo” de muchos desarrolladores es:
- Buscar todos los registros existentes
- Eliminarlos todos
- Insertar los nuevos
| |
El Error
| |
Por Qué Ocurre
El ChangeTracker de EF Core es un mapa de identidad en memoria. Cuando haces ToListAsync(), todas las entidades devueltas se rastrean con el estado Unchanged. Al llamar a RemoveRange(), el estado cambia a Deleted. Cuando se ejecuta SaveChangesAsync, las entidades se eliminan de la base de datos, pero el ChangeTracker todavía mantiene referencias a esas entidades con el mismo Id.
Si algún registro nuevo tiene el mismo Id que un registro que acaba de eliminarse, EF Core detecta la colisión y lanza la excepción. Aunque el registro ya se haya borrado de la base de datos, la identidad en memoria todavía existe en el contexto.
La Solución con EF Core Puro
| |
ChangeTracker.Clear() descarta todas las referencias rastreadas, lo que permite agregar nuevas entidades con los mismos Ids sin conflicto.
EF Core No Fue Diseñado Para Esto
Antes de culpar a EF Core, entiende quién está detrás de la herramienta. El equipo que mantiene Entity Framework Core no está compuesto solo por desarrolladores: son ingenieros de datos, arquitectos de bases de datos y especialistas con experiencia directa en proveedores como Oracle, SQL Server y PostgreSQL. Nombres como Arthur Vickers, Shay Rojansky (mantenedor de Npgsql) y Brice Lambson contribuyeron directamente a EF Core con décadas de experiencia en motores de bases de datos.
Si EF Core se comporta de determinada forma por defecto — como mantener el tracking activo e impedir que dos instancias con el mismo Id coexistan en el mismo contexto — no es un bug. Es una decisión arquitectónica fundamentada en principios de integridad de datos y concurrencia optimista.
El Propósito de EF Core
EF Core se diseñó para ser un ORM transaccional enfocado en:
- Unit of Work: agrupa cambios relacionados en una transacción atómica
- Identity Map: garantiza que cada registro de la base de datos tenga como máximo una representación en memoria
- Concurrencia optimista: detecta conflictos entre operaciones concurrentes
- OLTP (procesamiento transaccional): inserta, actualiza y elimina registros individuales o en lotes pequeños con seguridad transaccional
El comportamiento por defecto de EF Core es rastrear entidades porque la mayoría de los escenarios (APIs REST, CRUD, e-commerce) opera sobre decenas de registros por solicitud, no miles.
El Enfoque Correcto Para la Sincronización Masiva
Cuando el escenario exige procesar miles de registros — sincronización de inventario, importación de CSV, ingesta de datos desde colas — estás fuera del alcance de EF Core estándar. Aquí es donde entra EFCore.BulkExtensions.
En lugar de Delete + ReInsert, el enfoque correcto es un UPSERT (INSERT or UPDATE):
| |
Este enfoque:
- No necesita buscar primero los registros existentes
- No accede al ChangeTracker
- Ejecuta un
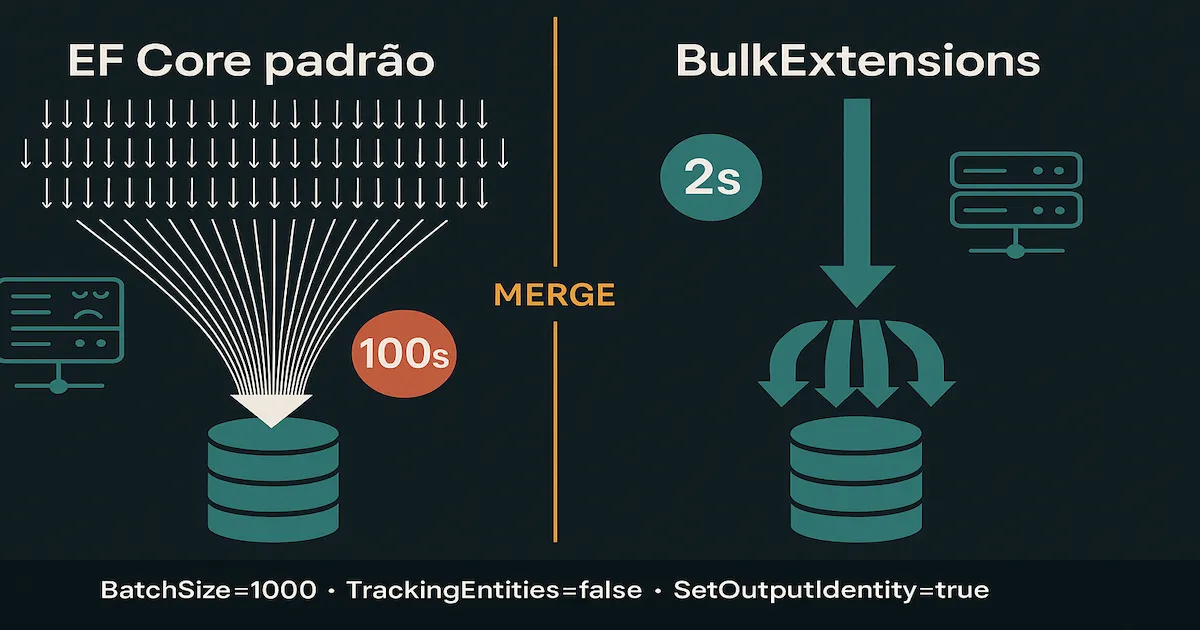
MERGEnativo en SQL Server (oINSERT ... ON CONFLICTen PostgreSQL) - Procesa 10.000 registros en ~2 segundos (vs. ~100 segundos con EF Core puro)
Si necesitas algo más que el UPSERT — eliminar registros que ya no existen en la fuente — usa BulkInsertOrUpdateOrDeleteAsync (sección 5 más abajo).
Instalación y Configuración
Instalación vía NuGet
| |
La biblioteca detecta automáticamente el provider de EF Core configurado. Para SQL Server, no se necesita ninguna configuración adicional. Para PostgreSQL, asegúrate de que Npgsql esté instalado.
| |
Compatibilidad
| EF Core | BulkExtensions | .NET |
|---|---|---|
| 8.x | 8.x | .NET 8+ |
| 7.x | 7.x | .NET 7+ |
| 6.x | 6.x | .NET 6+ |
Consejo: Usa siempre la misma major version de EFCore.BulkExtensions que tu EF Core. Ejemplo: EF Core
8.0.13→ BulkExtensions8.1.3.
Namespace
| |
Todos los métodos son extension methods de DbContext: no es necesario heredar de ninguna clase especial.
Todos los Métodos con Ejemplos Reales
A continuación, los 8 métodos principales de la biblioteca con ejemplos reales usando las entidades RegistroApp, ClienteApp y ConfiguracaoSegura del repositorio blog-zocateli-sample.
1. BulkInsertAsync — INSERT Masivo
Inserta miles de registros usando SqlBulkCopy (SQL Server) o COPY (PostgreSQL). Cero interacción con el ChangeTracker.
| |
Cuándo usarlo: Carga inicial de datos, importación de CSV, datos obtenidos de una base de datos diferente, ingesta de eventos.
2. BulkUpdateAsync — UPDATE Masivo
Actualiza registros existentes por clave primaria. Puedes elegir qué propiedades actualizar.
| |
Cuándo usarlo: Actualizar estados en lote, flags de procesamiento, campos calculados.
3. BulkDeleteAsync — DELETE Masivo
Elimina registros por clave primaria sin cargar antes las entidades.
| |
Cuándo usarlo: Eliminación periódica de datos expirados, limpieza de registros huérfanos, purga de datos antiguos.
4. BulkInsertOrUpdateAsync — UPSERT (MERGE)
El método más potente de la biblioteca. Ejecuta un MERGE en SQL Server: inserta registros nuevos y actualiza los existentes en una única operación.
| |
Cuándo usarlo: Sincronización con una fuente externa (API, CSV, Azure DevOps, datos de otra base de datos), ingesta de mensajes desde colas.
5. BulkInsertOrUpdateOrDeleteAsync — Sincronización Completa
Hace todo lo que hace el UPSERT, pero también elimina los registros que existen en la base de datos y no existen en la lista proporcionada. Es la sincronización delta completa.
| |
Cuándo usarlo: Sync total con un sistema maestro, espejado de catálogos, mirror de repositorios de Azure DevOps.
⚠️ Cuidado: Este método elimina de la base de datos todo lo que no esté en la lista. Úsalo con sabiduría y siempre en un contexto transaccional.
6. BulkSaveChangesAsync — Sustituto de SaveChangesAsync
Si ya usas el patrón Add/Update/Remove con el ChangeTracker, puedes simplemente cambiar SaveChangesAsync() por BulkSaveChangesAsync() para ganar rendimiento sin cambiar la lógica.
| |
Cuándo usarlo: Migración gradual de código existente: cambia SaveChangesAsync por BulkSaveChangesAsync sin refactorizar.
7. BulkReadAsync — Lectura en Lote por Clave
Carga registros de forma masiva por clave primaria o clave compuesta. Evita consultas N+1 cuando necesitas buscar entidades antes de un update en lote.
| |
Cuándo usarlo: Precargar entidades para compararlas antes de un update selectivo, validar existencia en lote.
8. TruncateAsync — TRUNCATE TABLE
Ejecuta un TRUNCATE TABLE nativo. A diferencia del DELETE sin WHERE, el truncate:
- No genera log de transacción por registro (minimal logging)
- Restablece identity/sequence a su valor inicial
- Es significativamente más rápido que delete en tablas grandes
| |
Cuándo usarlo: Limpieza de tablas de staging, reinicio de datos de prueba, recarga completa de una caché almacenada en la base de datos.
⚠️ Cuidado:
TRUNCATEno se puede filtrar y no dispara triggers. Úsalo solo en tablas que puedan vaciarse por completo.
BulkConfig: El Corazón de la Biblioteca
BulkConfig es la clase de configuración que controla el comportamiento de todas las operaciones bulk. Estas son las propiedades más importantes:
| Propiedad | Tipo | Descripción |
|---|---|---|
BatchSize | int | Registros por lote SQL. Por defecto: 2000. Recomendado: 500-2000. |
SetOutputIdentity | bool | Devuelve los IDs generados por la base de datos (identity/sequence) en los objetos de la lista. |
PreserveInsertOrder | bool | Garantiza que se respete el orden de la lista original en el INSERT. |
UpdateByProperties | List<string> | Propiedades usadas como clave para el Match en el MERGE/UPSERT. |
PropertiesToIncludeOnUpdate | List<string> | Whitelist: solo estas propiedades se actualizarán. |
PropertiesToExcludeOnUpdate | List<string> | Blacklist: estas propiedades no se actualizarán. |
TrackingEntities | bool | Si es false, no actualiza el ChangeTracker después de la operación. Usa siempre false por rendimiento. |
UseTempDB | bool | SQL Server: usa tempdb para el staging. Útil cuando hay restricciones de permisos. |
SqlBulkCopyOptions | SqlBulkCopyOptions | Opciones nativas de SqlBulkCopy (ej.: KeepIdentity, CheckConstraints). |
Ejemplo de BulkConfig Completo (Escenario Real)
Este es el patrón usado en producción para sincronizar registros de inventario de aplicaciones, basado en un proyecto real de gestión de inventario corporativo:
| |
Ejemplo Real: Inventario de Aplicaciones
Para demostrar el poder de la biblioteca en un escenario enterprise, veamos cómo un sistema de inventario corporativo usa BulkInsertOrUpdateAsync para sincronizar datos de cientos de repositorios de Azure DevOps.
El Escenario
Una empresa necesita mantener un inventario actualizado de todas sus aplicaciones: proyectos, repositorios, lenguajes, versiones de framework y secrets de Azure Key Vault. Un Worker Service se ejecuta periódicamente para:
- Consultar la API de Azure DevOps y listar todos los repositorios
- Extraer los metadatos (lenguaje, framework, etc.) de cada repositorio
- Sincronizar la base de datos mediante
BulkInsertOrUpdateAsync
El Repositorio
| |
El Mismo Patrón para Secrets
| |
Observa que el patrón es idéntico para entidades diferentes: lo que cambia son las propiedades de UpdateByProperties (clave compuesta para el MERGE) y PropertiesToExcludeOnUpdate (campos protegidos).
Integración con Azure Service Bus para Alto Volumen
Cuando el volumen de datos es realmente alto — decenas de miles de registros llegando en ráfagas — la mejor práctica es combinar mensajería con operaciones bulk. Como exploré en detalle en el artículo Cuello de Botella en Bases de Datos: Mensajería y Paginación, la mensajería (Azure Service Bus o RabbitMQ) funciona como buffer entre el productor de datos y la base de datos, lo que permite al Worker consumir en lotes optimizados.
El Patrón: Service Bus + BulkInsertOrUpdate
El flujo es:
| |
- El productor envía mensajes a la cola (uno por registro)
- El Worker consume hasta N mensajes a la vez (
ReceiveMessagesAsync) - Convierte los mensajes en entidades de dominio
- Persiste de forma masiva mediante
BulkInsertOrUpdateAsync - Confirma los mensajes procesados con
CompleteMessageAsync
Implementación
| |
Por Qué Funciona con Alto Volumen
| Sin BulkExtensions | Con BulkExtensions |
|---|---|
| 10.000 INSERT individuales | 1 BulkInsertOrUpdate con BatchSize = 1000 |
| ~100s (10ms × 10.000) | ~2-3s |
| 10.000 transacciones | 10 transacciones (10 batches de 1.000) |
| ChangeTracker con 10.000 entidades | Cero ChangeTracker |
Para profundizar en Workers y Background Services de alto volumen, lee el artículo Worker y Background Service en .NET: Alto Volumen.
Cuándo Usar (y Cuándo No Usar) BulkExtensions
✅ Úsala Cuando
- Carga inicial de datos (seed, migración, ETL)
- Sincronización periódica con una API externa (Azure DevOps, SAP, otras bases de datos, etc.)
- Procesamiento de colas (Azure Service Bus, RabbitMQ) con alto volumen
- Importación de CSV/Excel con miles de filas
- Actualización de estados en lote (flags, campos calculados)
- Limpieza periódica de datos expirados
❌ No la Uses Cuando
- CRUD simple con pocos registros por solicitud (EF Core estándar es suficiente)
- Operaciones que necesitan validación individual por registro con reglas de negocio complejas
- Escenarios en los que el ChangeTracker es necesario para auditoría o eventos de dominio
- Tablas con triggers complejos que deben dispararse por registro
Alternativas Nativas de EF Core 8+
EF Core 8 introdujo ExecuteUpdate y ExecuteDelete, que se ejecutan directamente en la base de datos sin pasar por el ChangeTracker:
| |
Estas alternativas son buenas para updates/deletes condicionales, pero no sustituyen a BulkInsertAsync, BulkInsertOrUpdateAsync ni BulkReadAsync, operaciones que EF Core nativo no ofrece.
Conclusión
EFCore.BulkExtensions es, sin duda, una de las bibliotecas más importantes del ecosistema .NET. Con más de 30 millones de descargas y una API consistente, cubre una carencia real de EF Core: las operaciones masivas con rendimiento nativo de base de datos.
Antes de culpar a EF Core por errores de tracking o de rendimiento, entiende el propósito de la herramienta: fue construida por ingenieros de datos que conocen a fondo SQL Server, PostgreSQL y Oracle. Si el comportamiento por defecto parece “incorrecto”, probablemente el escenario está fuera de su alcance.
Puntos clave:
- El error de tracking (delete + reinsert) es del desarrollador, no de EF Core: usa
ChangeTracker.Clear()o, mejor aún,BulkInsertOrUpdateAsync - TrackingEntities = false debe ser el valor por defecto en operaciones bulk
- UpdateByProperties define la clave lógica del MERGE: no necesita ser la PK
- PropertiesToExcludeOnUpdate protege campos como Id y CriadoEm de ser sobrescritos
- Combinado con Azure Service Bus, el patrón de consumo en lote + persistencia bulk es imbatible para alto volumen
📦 Código fuente: blog-zocateli-sample — DataAccess/BulkOperations
Al comentar, aceptas nuestra Política de Privacidad, Términos de Uso, Política de Eliminación de Datos.