
Introducción
Imagina la portería de una gran empresa — una corporación centenaria con decenas de sedes y 80.000 empleados activos en el registro. Son las 8 de la mañana de un lunes: cientos de personas llegan al mismo tiempo, cada una acercando su credencial a los torniquetes electrónicos. Para cada credencial, el sistema debe realizar una validación contra la base de datos corporativa: buscar el registro, verificar la situación, comprobar los permisos de acceso y registrar la entrada.
Si ese sistema es secuencial — procesando una validación a la vez, en fila — las personas se van a amontonar en la entrada. Con 80.000 registros y un tiempo de búsqueda de algunos milisegundos por consulta, la matemática es cruel. Aquí entra el paralelismo.
A diferencia de la programación asíncrona — que consiste en liberar el thread mientras se espera la I/O (lee más en Programación Asíncrona en C#: async/await y Threads) — el paralelismo consiste en usar múltiples núcleos de CPU simultáneamente para procesar tareas al mismo tiempo. Es la estrategia correcta cuando el cuello de botella está en el procesamiento y no en la espera de I/O.
En este artículo vas a entender qué es el paralelismo, cómo funciona en .NET, qué herramientas usar (Parallel.ForEach, PLINQ, Task.Run), cómo evitar las trampas clásicas de concurrencia y, sobre todo, cuándo tiene sentido usar cada enfoque — todo anclado en el ejemplo del torniquete corporativo.
📦 Código fuente: La implementación completa de este artículo está en el repositorio blog-zocateli-sample en GitHub. Clónalo, explóralo y adáptalo a tu contexto.
Requisitos Previos
- Familiaridad con C# y .NET (6+)
- Comprensión básica de threads y
Task - Recomendado: leer el artículo sobre programación asíncrona en C#
El Problema: El Torniquete Corporativo
Antes de escribir una línea de código, quiero entender el problema concreto.
La empresa TechCorp Centenária S.A. tiene:
- 80.000 empleados activos en 12 sedes
- Una base de datos corporativa legada con registros de control de acceso
- 200 torniquetes distribuidos en las entradas de todos los edificios
- Pico de acceso: 2.000 empleados presentándose en los primeros 15 minutos del turno
El sistema actual es simple: cuando se lee la credencial, se hace una búsqueda secuencial en una lista en memoria cargada desde la base de datos. El código original es este:
| |
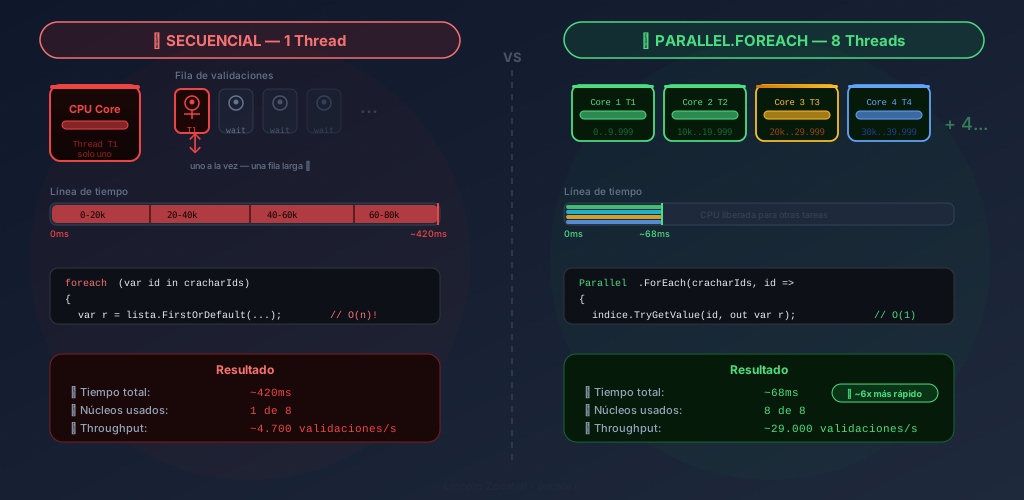
Con 80.000 registros y 2.000 validaciones llegando casi simultáneamente, el loop foreach procesa una a la vez. Es un problema CPU-bound: el procesador está trabajando, no esperando — pero está trabajando solo, en un único núcleo.
💡 Consejo: Distingue los problemas antes de elegir la solución. Pregúntate: “¿mi proceso está esperando datos (I/O-bound) o procesando datos (CPU-bound)?” Para I/O-bound usa async/await. Para CPU-bound usa paralelismo.
Asíncrono vs Paralelo: la Diferencia que lo Cambia Todo
Es fundamental tener clara esta distinción antes de continuar:
| Programación Asíncrona | Paralelismo | |
|---|---|---|
| Resuelve | Cuellos de botella de espera (I/O) | Cuellos de botella de procesamiento (CPU) |
| Cómo | Libera el thread durante la espera | Usa múltiples threads simultáneos |
| Herramienta | async/await, Task | Parallel, PLINQ, Task.Run |
| Ejemplo | Consulta a la base de datos | Procesar 80k registros en memoria |
| Núcleos usados | Eficiente con 1 núcleo | Aprovecha todos los núcleos disponibles |
En el problema del torniquete:
- Consultar la base de datos para cargar los registros → asíncrono (
ToListAsync()) - Procesar/validar los 80.000 registros en memoria → paralelo (
Parallel.ForEach)
Muchas soluciones reales combinan los dos patrones, y lo verás a lo largo de este artículo.
Cómo Funciona el Paralelismo en .NET
.NET administra los threads a través del ThreadPool — un conjunto de threads preasignados listos para usar. Cuando usas Parallel.ForEach o Task.Run, el runtime distribuye el trabajo entre los threads disponibles en el pool, mapeándolos a los núcleos físicos de la CPU.
Particionamiento Automático
La mayor ventaja de Parallel en .NET es el particionamiento automático: el runtime divide la colección en bloques (chunks) y distribuye cada bloque a un thread diferente. Esto evita el overhead de crear un thread por elemento.
| |
En una máquina con 8 núcleos, 80.000 registros se dividirían en ~8 particiones de 10.000, reduciendo el tiempo de procesamiento hasta 8x (en la práctica un poco menos por el overhead de sincronización).
Parallel.ForEach — La Solución para el Torniquete
La herramienta más directa para paralelizar un foreach es Parallel.ForEach. Así se transforma el código secuencial:
| |
⚠️ Atención: Observa el uso de
ConcurrentBag<T>en lugar deList<T>. UnaList<T>común no es thread-safe — múltiples threads agregando elementos simultáneamente causarían corrupción de datos o excepciones. Usa siempre colecciones del namespaceSystem.Collections.Concurrenten escenarios paralelos.
Controlando el Grado de Paralelismo
Por defecto, .NET usa todos los núcleos disponibles. En producción, eso puede ser demasiado agresivo — tal vez quieras limitarlo para no saturar el servidor ni afectar otros procesos:
| |
💡 Consejo: Un buen punto de partida para
MaxDegreeOfParallelismesEnvironment.ProcessorCount(número de núcleos lógicos de la máquina) oEnvironment.ProcessorCount / 2para dejar margen a otros procesos.
Acelerando la Búsqueda: Estructuras de Datos Correctas
Antes de paralelizar, verifica que la estructura de datos no sea el cuello de botella. En el ejemplo del torniquete, FirstOrDefault sobre una List<T> tiene complejidad O(n) — recorre toda la lista hasta encontrar el elemento. Con 80.000 registros, eso es caro.
La solución es preindexar los datos en un Dictionary<string, RegistroFuncionario>:
| |
ℹ️ Información:
Dictionary<TKey, TValue>no es thread-safe para escritura, pero es seguro para lecturas concurrentes cuando el diccionario no se está modificando. Como el índice se construye una sola vez y solo se lee en paralelo, este patrón es correcto. Si necesitas escritura concurrente, usaConcurrentDictionary<TKey, TValue>.
PLINQ: Paralelismo con la Elegancia de LINQ
PLINQ (Parallel LINQ) es una versión paralela del LINQ tradicional. Basta con agregar .AsParallel() a cualquier consulta LINQ para que el runtime distribuya automáticamente el procesamiento entre los threads.
| |
PLINQ con Ordenamiento
Un punto importante: PLINQ no garantiza el orden de los resultados por defecto. Si el orden importa (ej.: generar un reporte en orden de llegada), usa .AsOrdered():
| |
⚠️ Atención:
.AsOrdered()tiene un costo adicional de sincronización — los threads deben coordinar el orden de los resultados. Úsalo solo cuando realmente sea necesario.
Parallel.ForEachAsync — Combinando Paralelo y Asíncrono
El escenario real del torniquete es más rico: la validación involucra tanto procesamiento en memoria como consultas a la base de datos. Para eso, .NET 6+ ofrece Parallel.ForEachAsync — que combina paralelismo de CPU con operaciones asíncronas de I/O:
| |
Este es el patrón más poderoso: no bloquea threads durante la I/O (asíncrono) y usa múltiples núcleos para el procesamiento (paralelo).
ConcurrentDictionary: Estado Compartido sin Lock Manual
Además de ConcurrentBag, ConcurrentDictionary<TKey, TValue> es una de las estructuras más útiles en escenarios paralelos. Imagina que el torniquete necesita acumular estadísticas de acceso por sede:
| |
💡 Consejo:
ConcurrentDictionaryes mucho más eficiente que usar unDictionaryconlockmanual en escenarios de alta concurrencia de lectura/escritura, porque usa lock striping internamente — dividiendo el diccionario en segmentos independientes para minimizar la contención.
Controlando el Acceso a Recursos Limitados con SemaphoreSlim
En la vida real, los torniquetes tienen límites físicos — no puedes dejar pasar a 100 personas por la misma puerta al mismo tiempo. Lo mismo vale para el código: cuando tienes un recurso compartido limitado (conexiones a la base de datos, APIs externas, archivos), usa SemaphoreSlim para controlar el acceso concurrente:
| |
La metáfora es precisa: SemaphoreSlim es literalmente un semáforo — controla cuántos “pasos” simultáneos se permiten. WaitAsync espera un lugar; Release libera uno.
Thread Safety: Trampas Clásicas en el Paralelismo
Al paralelizar código, los errores más comunes son las race conditions — condiciones de carrera donde el resultado depende del orden impredecible de ejecución de los threads. Estos son los casos más frecuentes:
Contadores Compartidos
| |
Listas como Acumuladores
| |
Acceso a Recursos Externos (Base de Datos, Archivos)
| |
ℹ️ Información: El
DbContextde Entity Framework Core fue diseñado para ser scoped (uno por request). Nunca compartas un únicoDbContextentre threads — eso causa excepciones de concurrencia y resultados incorrectos. En paralelo, crea unDbContextpor iteración usandoIServiceScopeFactory.
Parallel.For vs Parallel.ForEach vs PLINQ
¿Cuál usar en cada situación?
| Escenario | Recomendación |
|---|---|
| Iterar una colección con índice | Parallel.For(0, n, i => ...) |
| Iterar una colección de objetos | Parallel.ForEach(colecao, item => ...) |
| Transformar una colección (proyección) | colecao.AsParallel().Select(...) |
| Filtrar y transformar | colecao.AsParallel().Where(...).Select(...) |
| Requiere I/O async + paralelismo | Parallel.ForEachAsync(colecao, async (item, ct) => ...) |
| Controlar recursos limitados | SemaphoreSlim + Task.WhenAll |
| |
Ejemplo Completo: Sistema de Torniquete en Producción
Ahora armo el escenario completo con todos los patrones aprendidos — desde la carga asíncrona de la base de datos hasta la validación paralela y el reporte final:
| |
Cuándo NO Usar Paralelismo
El paralelismo no es una bala de plata. Hay situaciones en las que empeora el rendimiento:
1. Colecciones pequeñas: El overhead de crear y sincronizar threads puede ser mayor que el beneficio. Para menos de ~1.000 elementos simples, el código secuencial suele ser más rápido.
2. Operaciones I/O-bound simples: Si el cuello de botella es la red o el disco, agregar threads no ayuda — el bottleneck sigue siendo externo. Usa async/await.
3. Operaciones que no pueden volverse thread-safe: Si el procesamiento de cada elemento depende del resultado de los anteriores (estado compartido obligatorio), el paralelismo agrega complejidad sin beneficio.
4. Código legado con efectos secundarios ocultos: Variables globales, singletons con estado mutable, logging no thread-safe — paralelizar código así genera bugs difíciles de reproducir.
| |
Midiendo la Diferencia: Benchmark
Para sentir la diferencia en la práctica, aquí hay un benchmark simple usando System.Diagnostics.Stopwatch:
| |
💡 Consejo: Para benchmarks serios, usa la biblioteca BenchmarkDotNet — controla variables como el JIT warm-up, el GC y la varianza estadística, generando resultados mucho más confiables.
Resumen: Cuándo Usar Cada Herramienta
| Herramienta | Mejor Para | Evitar Cuando |
|---|---|---|
Parallel.For | Arrays con índice, gran volumen, CPU-bound | Colecciones pequeñas |
Parallel.ForEach | Colecciones de objetos, CPU-bound | Operaciones con I/O pura |
PLINQ (.AsParallel()) | Pipelines de transformación/filtro | Cuando el orden importa (costo) |
Parallel.ForEachAsync | CPU + I/O (async dentro del paralelo) | CPU pura simple |
Task.WhenAll + SemaphoreSlim | Controlar la tasa de I/O concurrente | CPU-bound pesado |
ConcurrentDictionary | Estado compartido con mucha escritura | Solo lectura (usa Dictionary) |
Interlocked | Contadores y flags atómicos | Estructuras complejas |
Conclusión
El ejemplo del torniquete corporativo es perfecto para ilustrar cuándo y por qué importa el paralelismo. Una empresa centenaria no puede tener empleados esperando en la fila porque el sistema procesa una credencial a la vez. Con Parallel.ForEach, PLINQ y las colecciones concurrentes de .NET, es posible transformar procesos que tardaban cientos de milisegundos en decenas — o menos.
Los puntos fundamentales para recordar:
- El paralelismo es para CPU-bound — cuando el procesador está trabajando, no esperando
- Combínalo con async/await en escenarios que involucran I/O
- Usa siempre colecciones thread-safe (
ConcurrentBag,ConcurrentDictionary) para acumular resultados - Controla el grado de paralelismo con
MaxDegreeOfParallelism— “máximo” no siempre es “mejor” - Usa
SemaphoreSlimpara proteger recursos limitados (conexiones, APIs externas) - Mide antes y después — el paralelismo mal aplicado puede ser más lento que el código secuencial
💡 Consejo Final: C# y el ecosistema .NET ofrecen una de las implementaciones de paralelismo más completas y mejor documentadas del mercado. La TPL (Task Parallel Library), PLINQ y las colecciones concurrentes forman parte del runtime estándar — sin dependencias externas, sin configuración adicional. Si estás construyendo sistemas que necesitan escalar, C# es una excelente elección por su madurez en este dominio. Para profundizar, explora también Channels y System.Threading.Tasks.Dataflow para pipelines de alto rendimiento.
Lee También
- Programación Asíncrona en C#: async/await y Threads
- Cuello de Botella en Bases de Datos: Mensajería y Paginación
- Paginación en APIs REST con C# y EF Core: Guía Práctica
- Worker y Background Service en .NET: Alto Volumen
Referencias
- Task Parallel Library (TPL) — Microsoft Docs
- Parallel LINQ (PLINQ) — Microsoft Docs
- System.Collections.Concurrent — Microsoft Docs
- Parallel.ForEachAsync — .NET 6+ — Microsoft Docs
- BenchmarkDotNet — Biblioteca de Benchmarks para .NET
- Programación Asíncrona en C# — zocate.li
- Repositorio blog-zocateli-sample — AsyncParallel — Código fuente completo de los ejemplos de este artículo
Al comentar, aceptas nuestra Política de Privacidad, Términos de Uso, Política de Eliminación de Datos.